<?xml version="1.0" encoding="utf-8"?><feed xmlns="http://www.w3.org/2005/Atom" ><generator uri="https://jekyllrb.com/" version="3.10.0">Jekyll</generator><link href="https://jasonyanglu.github.io/feed.xml" rel="self" type="application/atom+xml" /><link href="https://jasonyanglu.github.io/" rel="alternate" type="text/html" /><updated>2026-08-15T17:20:46-07:00</updated><id>https://jasonyanglu.github.io/feed.xml</id><title type="html">Yang Lu  (卢杨)</title><subtitle>personal description</subtitle><author><name>Yang Lu (卢杨)</name><email>luyang@xmu.edu.cn</email></author><entry><title type="html">论文解读Attention Is All You Need</title><link href="https://jasonyanglu.github.io/posts/2019/07/blog-post-4/" rel="alternate" type="text/html" title="论文解读Attention Is All You Need" /><published>2019-07-02T00:00:00-07:00</published><updated>2019-07-02T00:00:00-07:00</updated><id>https://jasonyanglu.github.io/posts/2019/07/blog-post-4</id><content type="html" xml:base="https://jasonyanglu.github.io/posts/2019/07/blog-post-4/"><![CDATA[<p>Google提出的语言模型Transformer，抛弃了传统的CNN和RNN，整个网络结构完全是由Attention机制组成。</p>

<h2 id="动机">动机</h2>

<ul>
  <li>
    <p>传统词向量训练所有词无论在哪个句子中的哪个位置，其词向量都是固定的，不能够表达句子以及其context的含义。</p>
  </li>
  <li>
    <p>RNN（或者LSTM，GRU等）的计算限制为是顺序的，也就是说RNN相关算法只能从向右依次计算或者从右向左依次计算，这种机制带来了两个问题：</p>

    <ol>
      <li>
        <p>时间片t的计算依赖t-1时刻的计算结果，这样限制了模型的并行能力；</p>
      </li>
      <li>
        <p>顺序计算的过程中信息会丢失，尽管LSTM等门机制的结构一定程度上缓解了长期依赖的问题，但是对于特别长期的依赖现象，LSTM依旧无能为力。</p>
      </li>
    </ol>
  </li>
</ul>

<h2 id="框架">框架</h2>

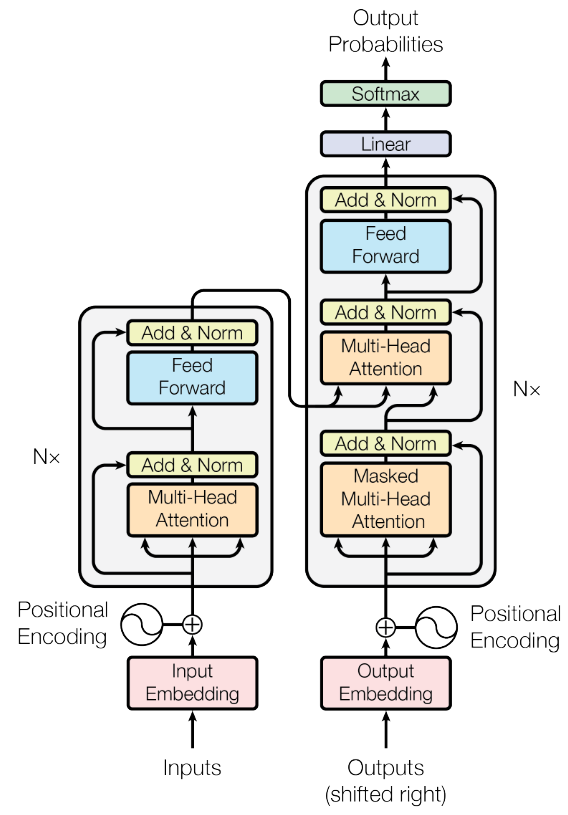
<p>Transformer中抛弃了传统的CNN和RNN，整个网络结构完全是由Attention机制组成。更准确地讲，Transformer由且仅由self-Attenion和Feed Forward Neural Network组成。一个基于Transformer的可训练的神经网络可以通过堆叠Transformer的形式进行搭建，作者的实验是通过搭建编码器和解码器各6层，总共12层的Encoder-Decoder。</p>

<p>为了解决RNN的问题，transformer只用了attention机制，抛弃了传统RNN或CNN结构，将序列中的任意两个位置之间的距离是缩小为一个常量；其次它不是类似RNN的顺序结构，因此具有更好的并行性，符合现有的GPU框架。</p>

<h2 id="attention-network">Attention Network</h2>

<p>attention起源于cv，在nlp领域最早用于seq2seq与机器翻译。在使用RNN作为encoder时每个token输出一个定长的hidden representation，如果要在decoder端根据整个句子的信息进行预测每个翻译出来的词的概率，仅通过encoder端最终输出的一个定长向量很难表达token之间的交互信息。attention解决了这个信息瓶颈问题 [1]：</p>

<blockquote>
  <p>An attention network maintains a set of hidden representations that scale with the size of the source. The model uses an internal inference step to perform a soft-selection over these representations. This method allows the model to maintain a variable-length memory and has shown to be crucially important for scaling systems for many tasks.</p>
</blockquote>

<p>给定input序列 $x=[x_1, x_2, …, x_n]$，q是一个query，z是一个categorical variable，其取值是{1,…,n}，代表根据q从x中选择相关的input。attention的目标就是根据q和x的信息生成一个上下文c。通过计算z的分布$z\sim p(z\rvert x, q)$，c可以写为期望的形式：</p>

\[c=\mathbb{E}_{z\sim p(z\rvert x,q)}[f(x,z)]\]

<p>$f(x,z)$叫做annotation function，定义了x和z如何组合。具体来说，在一个基于RNN的机器翻译网络中，input x就是encoder RNN中每个节点的隐层，q就是decoder RNN中某个节点的隐层，z代表了翻译原文input的位置，也就是与当前decoder输入的词最相关的input的词。此时c的计算可写为：</p>

\[c=\sum_{i=1}^np(z=i\rvert x,q)x_i\]

<p>其中$p(z=i\rvert x,q)=softmax(MLP(x_i; q))$。即根据q和x的关系来线性组合x。如果是self-attention的话，q就是x本身。</p>

<p><img src="https://camo.githubusercontent.com/a3c087bfca2eb44553f284ac13b19ccc27a333ed/68747470733a2f2f332e62702e626c6f6773706f742e636f6d2f2d3350626a5f64767430566f2f562d71652d4e6c365035492f41414141414141414251632f7a305f365774565774764152744d6b3069395f41744c6579794779563641493477434c63422f73313630302f6e6d742d6d6f64656c2d666173742e676966" alt="" /></p>

<p>(图片来源：https://github.com/google/seq2seq)</p>

<h2 id="scaled-dot-product-attention">Scaled Dot-Product Attention</h2>

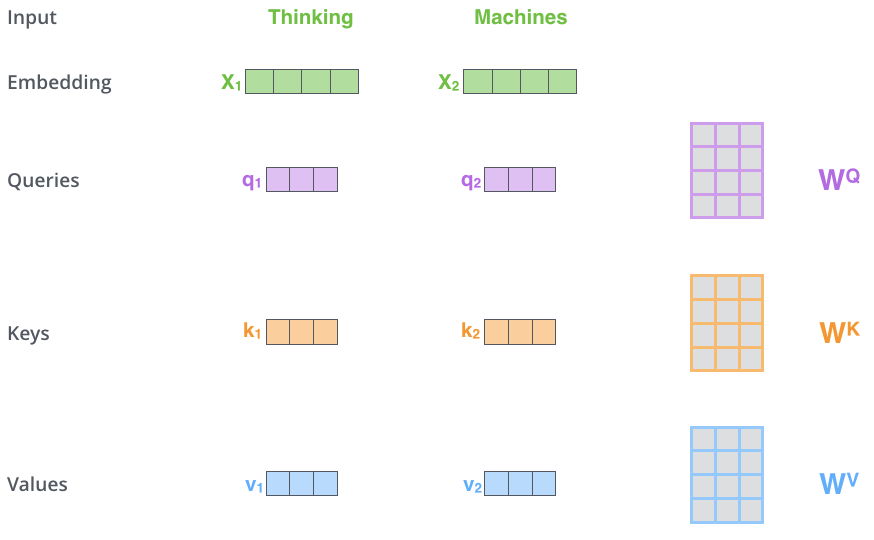
<p>Self-attention是一种attention机制，用来计算一个句子（中的token）的represetation，其包含了这个句子中token不同位置的关系。文章中引入了3个变量，Q，K，V。分别代表query，key，value。这3个变量都是由input embedding X与参数矩阵乘积得到的。</p>

<p><img src="https://jasonyanglu.github.io/images/2019-07-02-blog-post-4.assets/0.png" alt="" /></p>

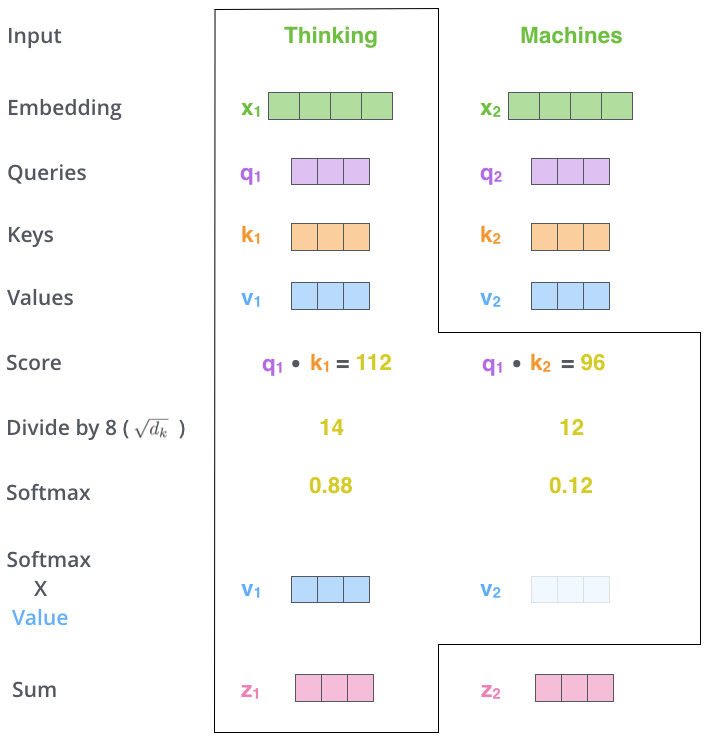
<p>q代表当前中心词的attention representation，k表示周围词的attention representation。q与k相当于word2vec中的input &amp; output embedding。k用来与q相乘得到attention score，得到词与词在句子中的相关性，v用来被softmax之后的attention score加权，加权和之后作为输出。</p>

<p><img src="https://jasonyanglu.github.io/images/2019-07-02-blog-post-4.assets/1.png" alt="" /></p>

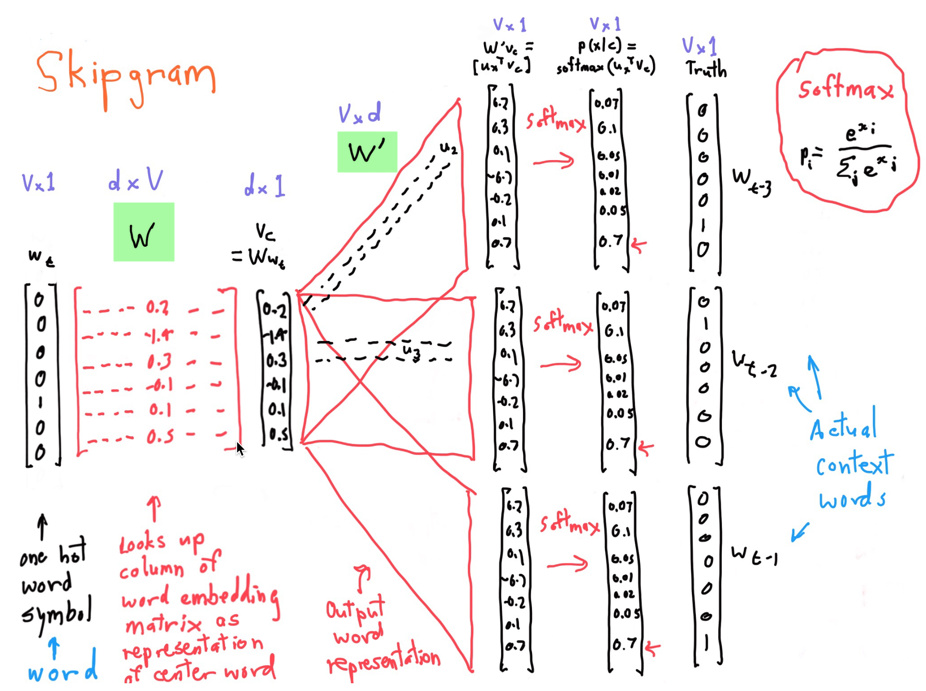
<p>其中，由于矩阵乘法会改变数值量纲，所以在分母中添加$\sqrt{d_k}$。对比一下万宁画的skipgram：</p>

<p><img src="https://jasonyanglu.github.io/images/2019-07-02-blog-post-4.assets/2.png" alt="" /></p>

<p>区别在于skipgram输入的是onehot，而transformer的input已经是词的embedding了。</p>

<h2 id="multi-head-attention">Multi-head Attention</h2>

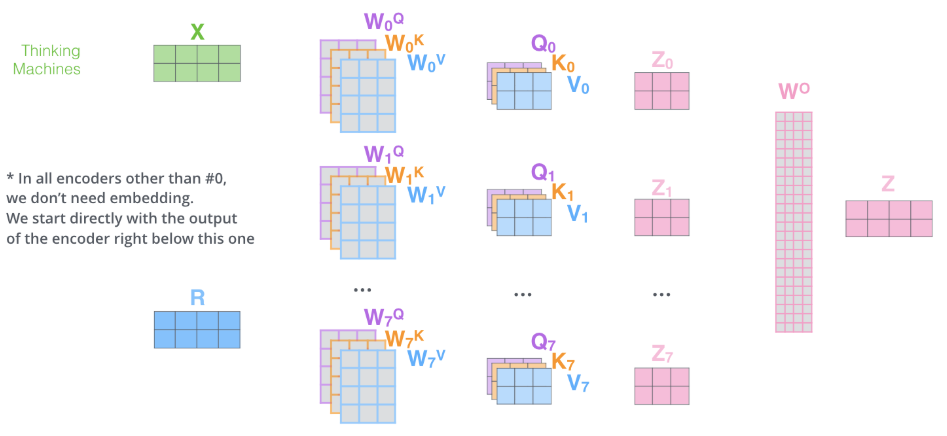
<p>一组attention的权重参数只能够表达一种词与词之间的关系，在nlp任务中，一种关系可能不足以表达。所以通过配置多组attention权重矩阵，最后通过线性组合，来综合表达：</p>

<p><img src="https://jasonyanglu.github.io/images/2019-07-02-blog-post-4.assets/3.png" alt="" /></p>

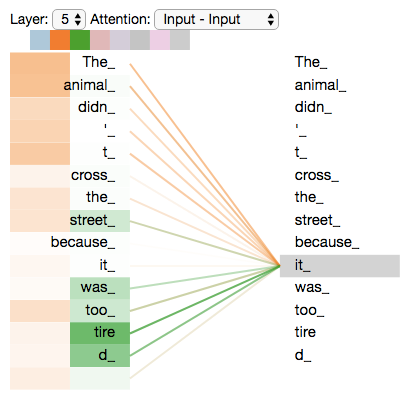
<p>下图是一个2 head attention，从中可以看出，一个head关注到it所指代的东西”the animal”。另一个head侧重点在”tired”，表示该主语所对应的谓语。</p>

<p><img src="https://jasonyanglu.github.io/images/2019-07-02-blog-post-4.assets/4.png" alt="" /></p>

<h2 id="position-wise-feed-forward-networks">Position-wise Feed-Forward Networks</h2>

<p>每个attention的输出后面再接上一个权重共享的mlp，类似于RNN输出的h上面再接一层mlp作为输出。我觉得要加这个sub-layer的原因是再加一层激活函数，之前attention在qk内积之后加了softmax之后就再也没有非线性变换了。</p>

<h2 id="positional-encoding">Positional Encoding</h2>

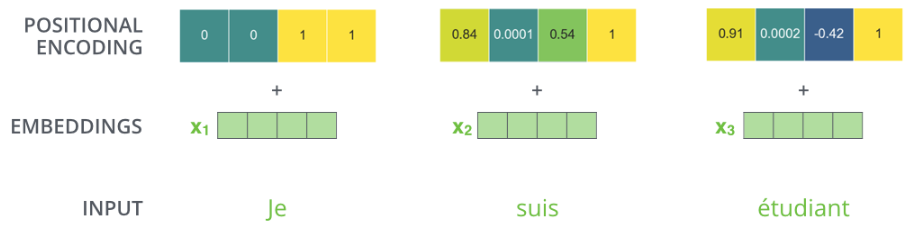
<p>单纯使用attention没有办法将序列的位置信息融入表达。</p>

\[PE_{(pos,2i)}=sin(pos/1000^{2i/d_{model}})\\PE_{(pos,2i+1)}=cos(pos/1000^{2i/d_{model}})\]

<p>其中pos是token的位置，i是第i维embedding。</p>

<p><img src="https://jasonyanglu.github.io/images/2019-07-02-blog-post-4.assets/5.png" alt="" /></p>

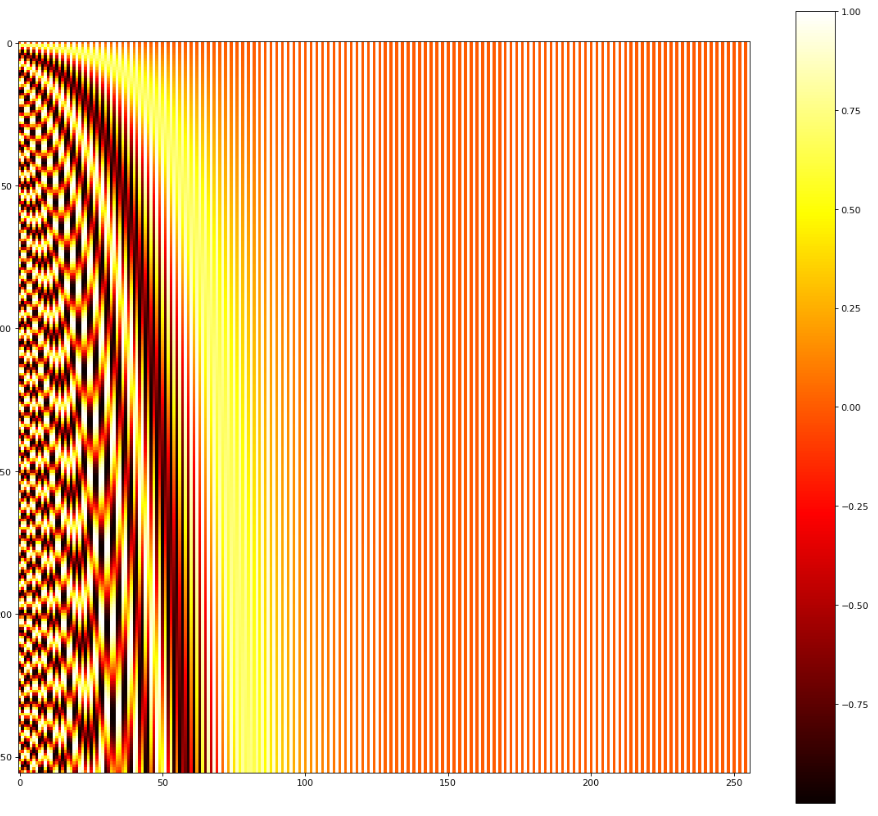
<p>用seq_len=256，emb_size=256，positional encoding（横轴是i，纵轴是pos）：</p>

<p><img src="https://jasonyanglu.github.io/images/2019-07-02-blog-post-4.assets/6.png" alt="" /></p>

<p>用positional encoding而不是positional embedding的原因是什么？</p>

<p>文中提到使用positional embedding的效果也差不多，但是依然使用positional encoding的原因是：</p>

<blockquote>
  <p>It may allow the model to extrapolate to sequence lengths longer than the ones encountered during training.</p>
</blockquote>

<p>知乎评论：positional encoding看起来就像是magic number。</p>

<h2 id="model-architechture">Model Architechture</h2>

<p><img src="https://jasonyanglu.github.io/images/2019-07-02-blog-post-4.assets/7.png" alt="" /></p>

<ol>
  <li>
    <p>Residual connection</p>

    <p>和图像中的residual使用目的一样，让底层的有效信息直接传递给高层。</p>
  </li>
  <li>
    <p>Encoder and Decoder Stacks</p>

    <p>encoder和decoder各6层stack。decoder中的结构和encoder略有不同，decoder中的第一个sublayer的multi-head attention加了一个mask，把位置i之后的给遮掉了，只让第i个query和它之前的token做attention，防止信息泄露。因为目标是预测下一个词，所以不能用到之后的词来预测自己。</p>
  </li>
  <li>
    <p>Decoder中的两层multi-head attention</p>

    <p>第一个是对output sequence中之前出现的词做attention加权。第二个是对input sequence中的词做attention加权，用第一层输出的q，和encoder输出的k，v做加权。（参考attention network小节中的图）</p>
  </li>
</ol>

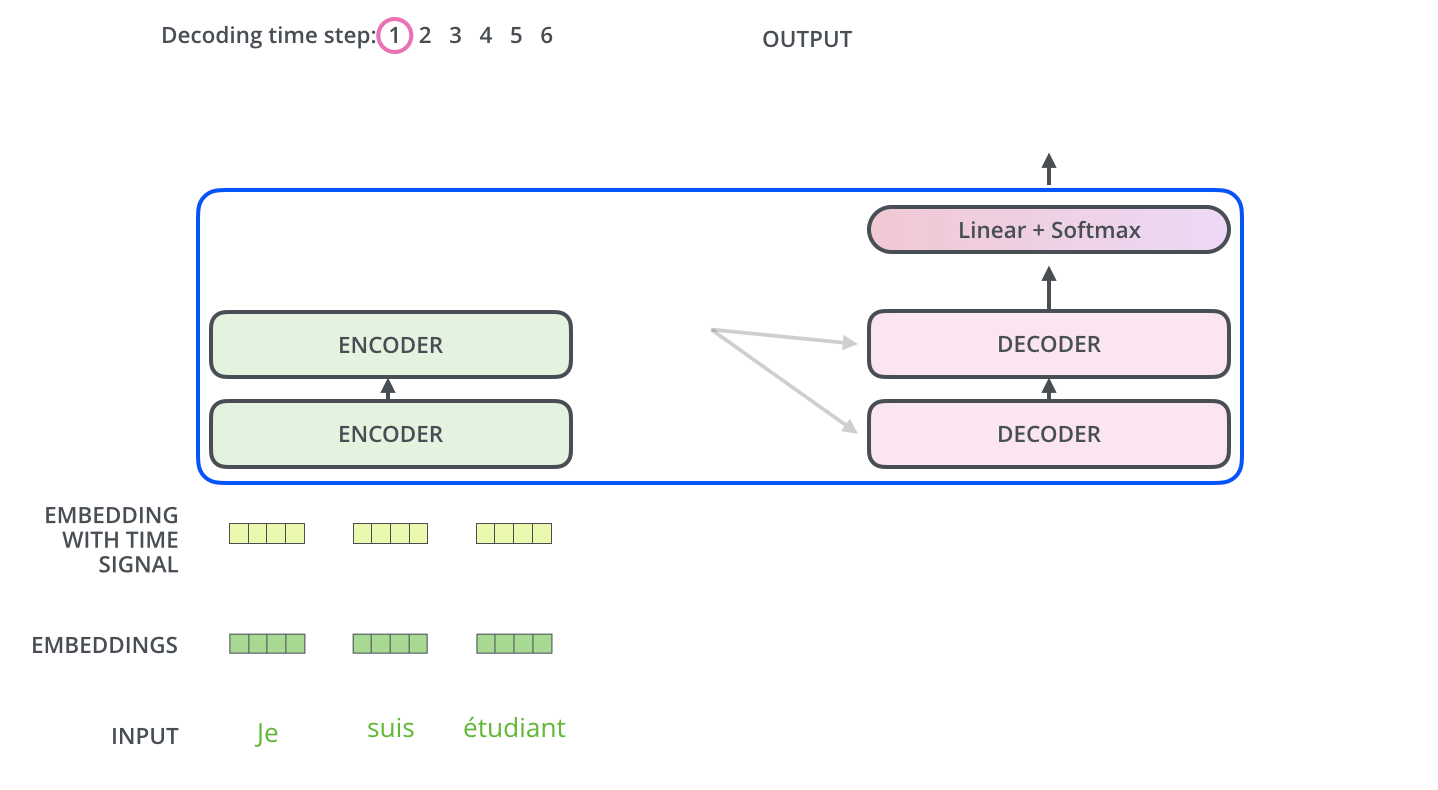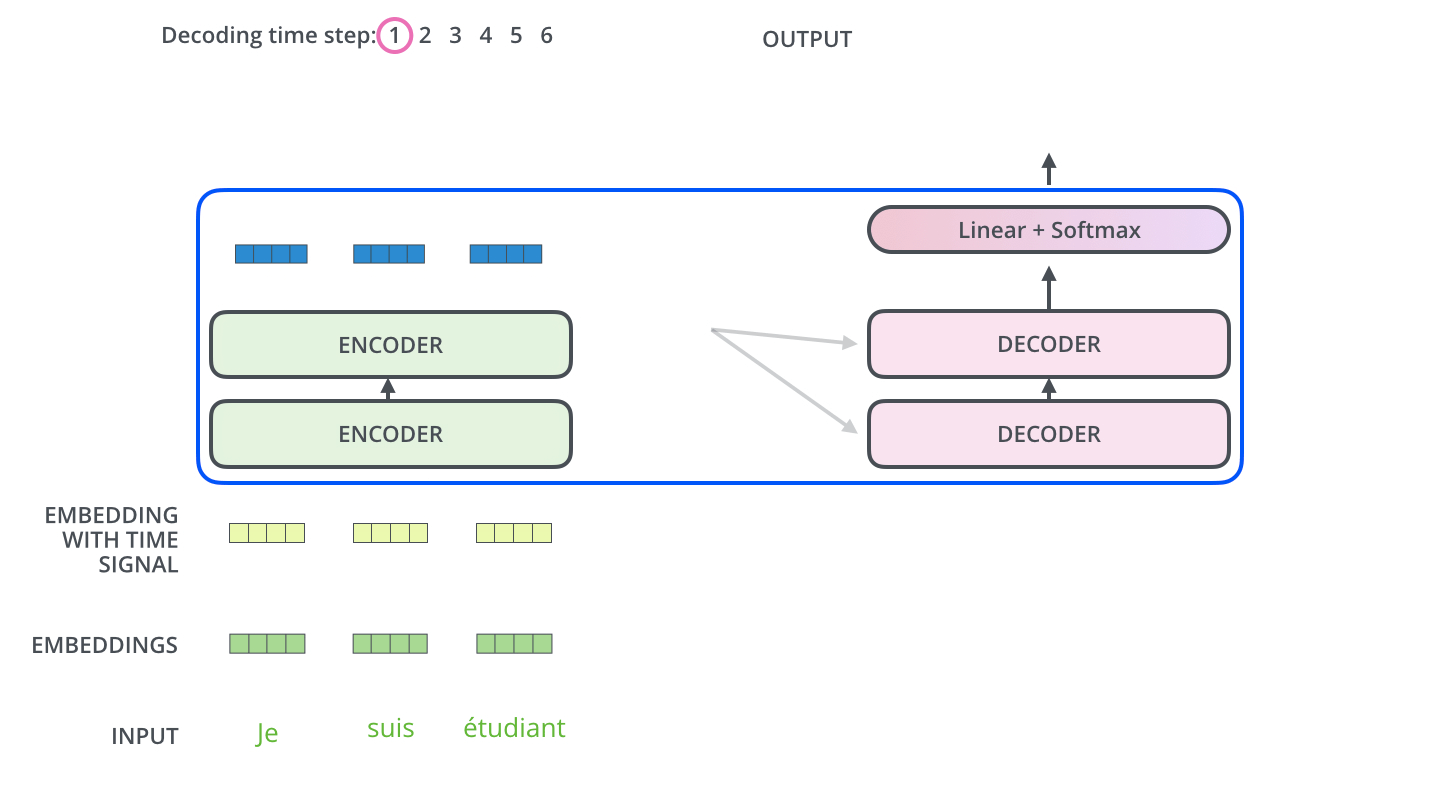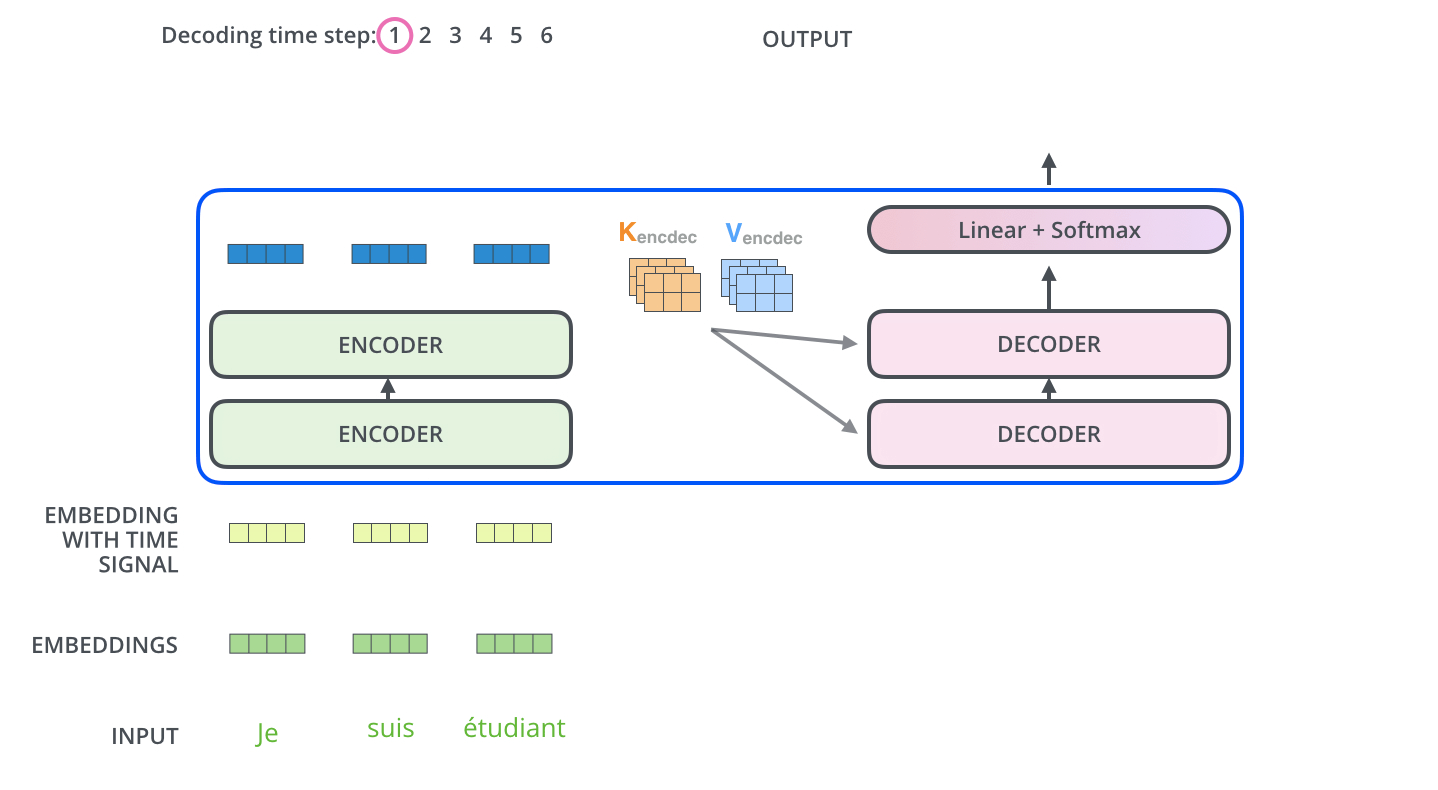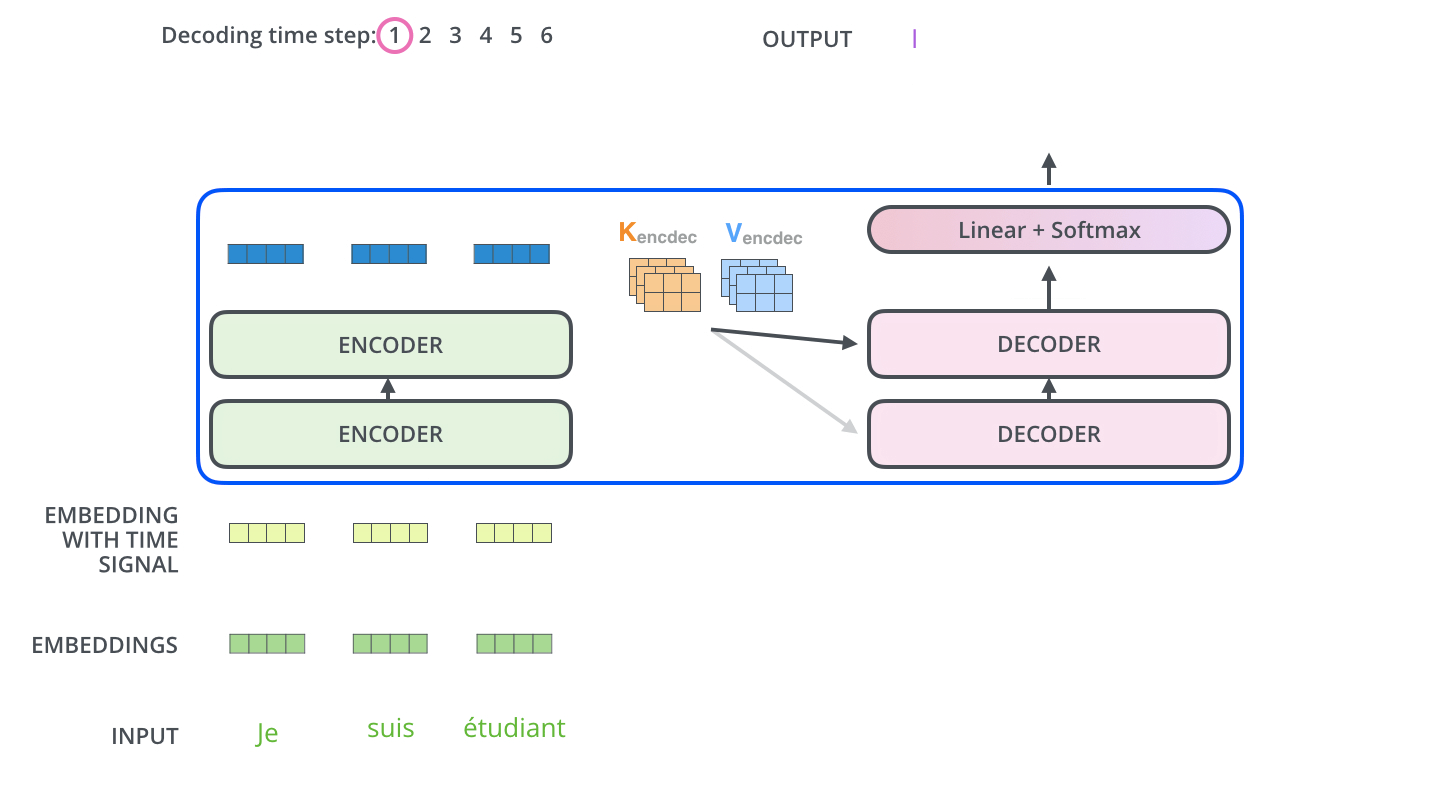
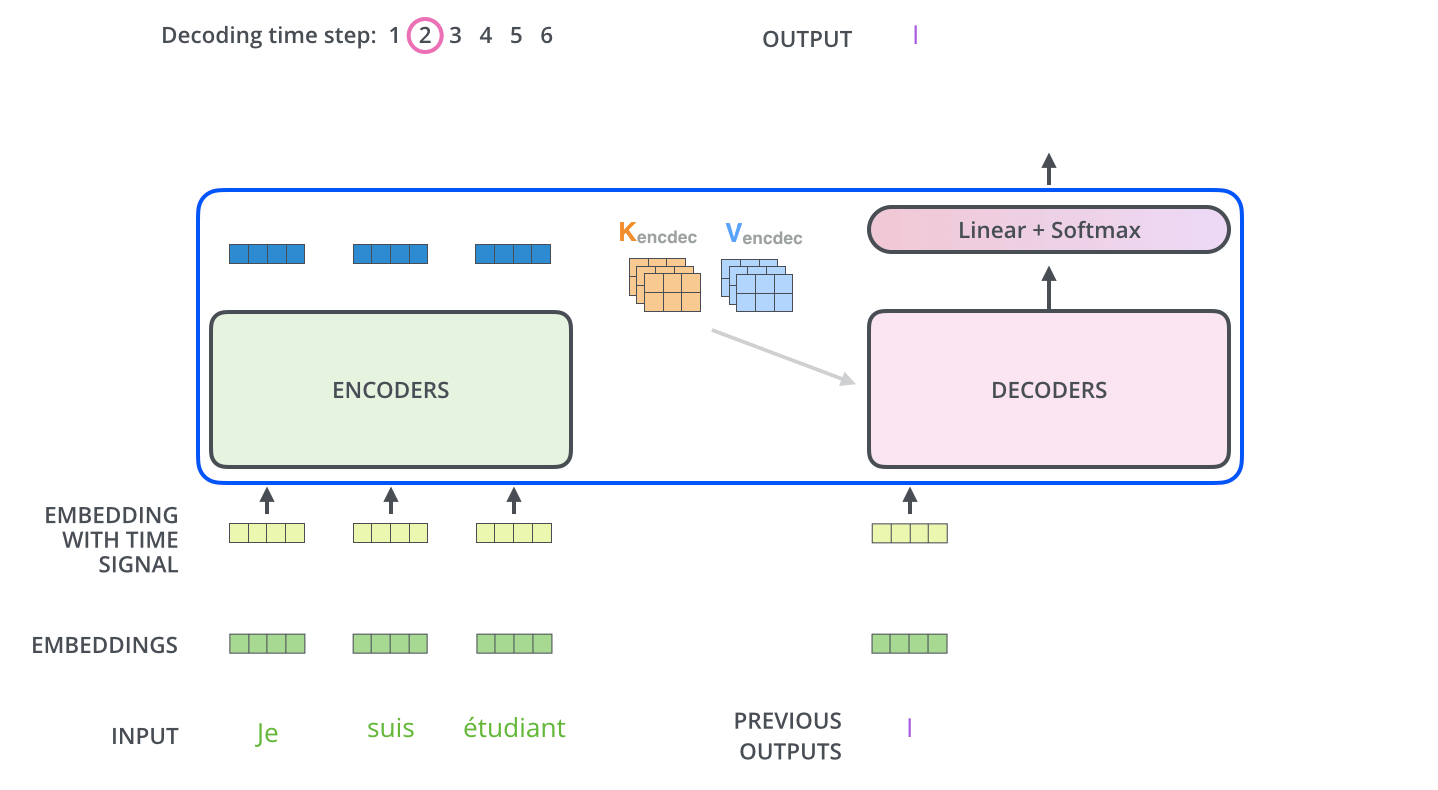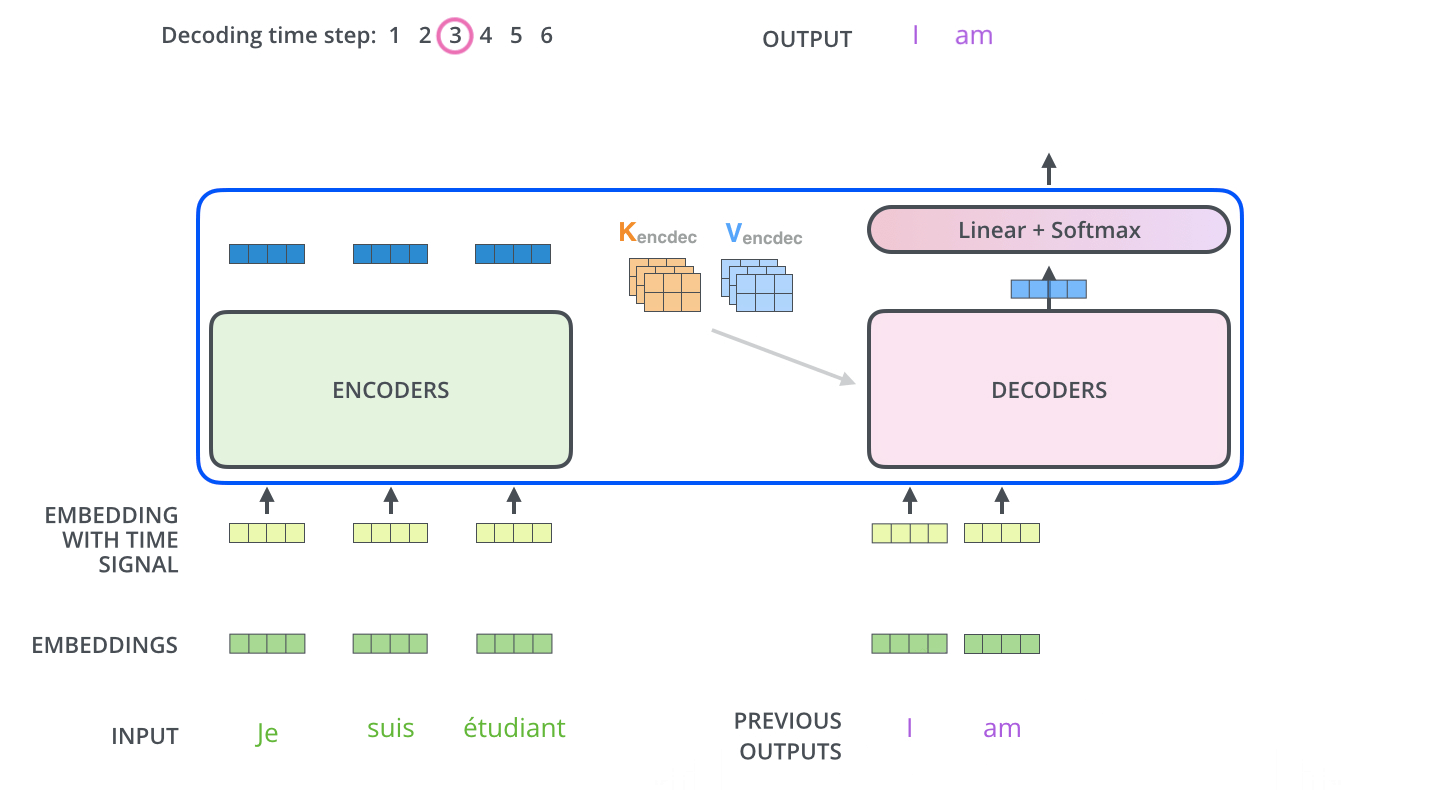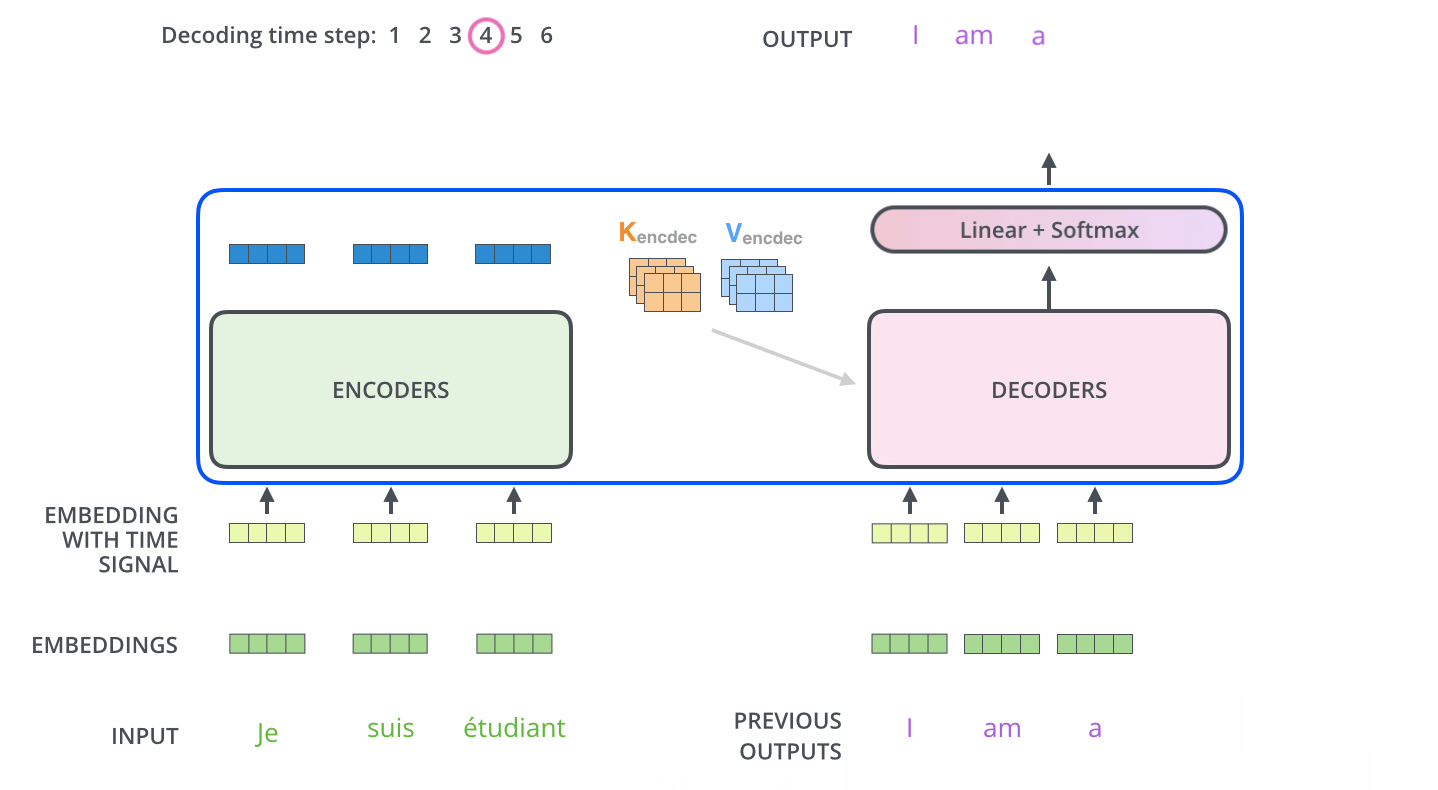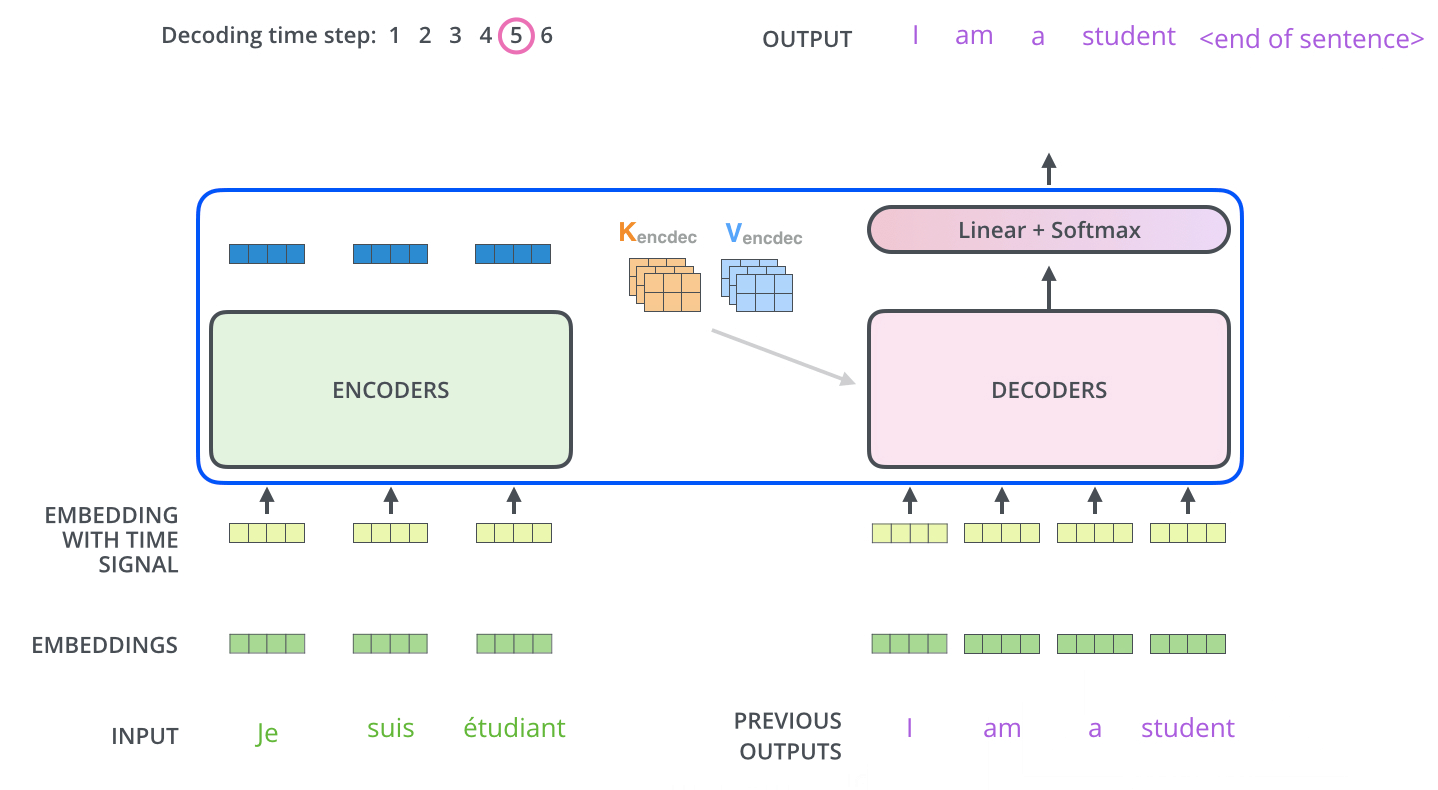
<p>动图演示transformer如何翻译：</p>

<p><img src="http://jalammar.github.io/images/t/transformer_decoding_1.gif" alt="" /></p>

<p><img src="http://jalammar.github.io/images/t/transformer_decoding_2.gif" alt="" /></p>

<h2 id="参考">参考</h2>

<p>[1] Kim, Y., Denton, C., Hoang, L., &amp; Rush, A. M. (2017). Structured Attention Networks. In ICLR.</p>

<p>http://jalammar.github.io/illustrated-transformer/</p>

<p>https://zhuanlan.zhihu.com/p/48508221</p>]]></content><author><name>Yang Lu (卢杨)</name><email>luyang@xmu.edu.cn</email></author><category term="NLP" /><category term="Attention" /><category term="论文解读" /><summary type="html"><![CDATA[Google提出的语言模型Transformer，抛弃了传统的CNN和RNN，整个网络结构完全是由Attention机制组成。]]></summary></entry><entry><title type="html">论文解读Real-time Personalization using Embeddings for Search Ranking at Airbnb</title><link href="https://jasonyanglu.github.io/posts/2019/07/blog-post-5/" rel="alternate" type="text/html" title="论文解读Real-time Personalization using Embeddings for Search Ranking at Airbnb" /><published>2019-07-02T00:00:00-07:00</published><updated>2019-07-02T00:00:00-07:00</updated><id>https://jasonyanglu.github.io/posts/2019/07/blog-post-5</id><content type="html" xml:base="https://jasonyanglu.github.io/posts/2019/07/blog-post-5/"><![CDATA[<p>这篇文章是airbnb提出的一种构造item embedding的方式。该方法将应用领域的需求与算法高度结合。</p>

<h2 id="论文贡献">论文贡献</h2>

<ul>
  <li>Real-time Personalization - 实时个性化。相比之前工作离线构建user-item和item-item表进行训练，这篇文章提出在线方法训练最近交互的物品的embeddings然后计算相似度进行排序。</li>
  <li>Adapting Training for Congregated Search - 面向聚合搜索自适应训练。在负采样的时候进行了调整，学习不同地方的相似性。</li>
  <li>Leveraging Conversions as Global Context - 限定窗口的重要性，在每个对话中的click sessions构建list embeddings。</li>
  <li>User Type Embeddings - 当用户和listing ID稀疏时，使用user type和listing type级别上训练type embedding。</li>
  <li>Rejections as Explicit Negatives - 将房东拒绝出租的case作为训练中明确的负样本。</li>
</ul>

<h2 id="论文架构">论文架构</h2>

<ol>
  <li>Listing embeddings: 通过用户在一个session中的短期点击行为来训练房源的id embedding。</li>
  <li>User-type &amp; listing-type embeddings: 通过用户的历史消费行为来训练用户和房源的type embedding。</li>
  <li>Experiment：描述了如何将训练得到的embedding用在真实的推荐场景中。</li>
</ol>

<h2 id="listing-embeddings">Listing Embeddings</h2>

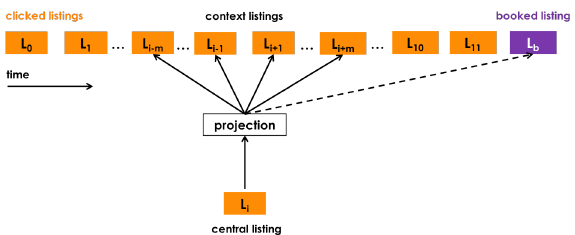
<p><img src="https://jasonyanglu.github.io/images/2019-07-02-blog-post-5.assets/0.png" class="center" /></p>

<h3 id="应用原始skip-gram算法在airbnb场景">应用原始Skip-gram算法在Airbnb场景</h3>

<ul>
  <li>点击会话 (Session) ，每个会话$s=(L_1, …, L_n)\in S$定义为一个由用户点击的 n 个房源 id 组成的的不间断序列。</li>
  <li>只要用户连续两次点击之间的时间间隔超过30分钟，第二次点击会被认为是一个新的会话的开始。</li>
  <li>目标是学习一个 32 维的实值表示方式 ，使相似房源在Embedding空间中处于临近的位置。</li>
  <li>在每一步中，将中央房源的向量更新并将其推向正向相关房源的向量（用户在点击中心房源前后点击的其他房源，滑动窗口长度为m=5），并通过随机抽样房源的方式将它从负向相关房源推开（因为这些房源很大几率与中央房源没有关系）。</li>
</ul>

<h3 id="创新点">创新点</h3>

<ul>
  <li><strong>用最终预订的房源作为全局上下文 (Global Context)</strong> ：使用以用户预订了房源（上图中紫色标记）为告终的用户会话来做这个优化，在这个优化的每个步骤中不仅预测相邻的点击房源，还会预测最终预订的房源。 当窗口滑动时，一些房源会进入和离开窗口，而预订的房源始终作为全局上下文（图中虚线）保留在其中，并用于更新中央房源向量。</li>
  <li><strong>适配聚集搜索的场景</strong>：在线旅行预订网站的用户通常仅在他们的旅行目的地内进行搜索。 因此，对于给定的中心房源，正相关的房源主要包括来自相同目的地的房源，而负相关房源主要包括来自不同目的地的房源，因为它们是从整个房源列表中随机抽样的。 但这种不平衡会导致在一个目的地内相似性不是最优的。所以在训练embedding时再加上了一个相同目的地下没被点击的负样本来加强同一位置的房源相似度的区分。</li>
  <li><strong>冷启动Embedding</strong>：每天在 Airbnb 上都有新的房源提供。这些房源在新建时还不在训练数据集中，所以没有嵌入信息。 要为新房源创建嵌入，会找到 3 个地理位置最接近、房源类别和价格区间相同的已存在的房源，并计算这些房源嵌入的向量平均值来作为新房源的嵌入值。</li>
</ul>

<p><img src="https://jasonyanglu.github.io/images/2019-07-02-blog-post-5.assets/1.png" alt="" /></p>

<h3 id="离线评估">离线评估</h3>

<ul>
  <li>在对使用了嵌入的推荐系统进行线上搜索测试之前进行了多次离线测试。同时还使用这些测试比较了多种不同参数训练出来的不同嵌入，以快速做优化，决定嵌入维度、算法修改的不同思路、训练数据的构造、超参数的选择等。</li>
  <li>评估Embedding的一种方法是测试它们通过用户最近的点击来推荐的房源，有多大可能最终会产生预订。更具体地说，假设获得了最近点击的房源和需要排序的房源候选列表，其中包括用户最终预订的房源；通过计算点击房源和候选房源在嵌入空间的余弦相似度可以对候选房源进行排序，并观察最终被预订的房源在排序中的位置。</li>
  <li>搜索中的房源根据Embedding空间的相似性进行了重新排序，并且最终被预订房源的排序是按照每次预定前的点击的平均值来计算。</li>
</ul>

<h2 id="user-type--listing-type-embeddings">User-type &amp; listing-type embeddings</h2>

<h3 id="动机">动机</h3>

<p>在session内的embedding比较适合短期的个性化推荐，其目标是给用户展示跟刚刚点击过的房源相似的房源。但是用户的长期消费行为历史对于个性化推荐也十分有用。例如，一个用户正在搜索洛杉矶的房源，他曾经订过纽约和伦敦的房源，给他推荐和他以前订过的房源相似的房源是有帮助的。但是通过用户的历史消费来训练embedding会带来一些挑战：</p>

<ol>
  <li>相比于点击行为，用户的历史消费行为很少。</li>
  <li>有一些用户曾经只消费过一次，只有一个item的list没办法训练embedding。</li>
  <li>通常5-10个item的list才能够训练出较好的embedding，但是多数用户并没有5-10次消费记录。</li>
  <li>用户的历史消费记录可能有较长的时间跨度，用户的喜好会发生转变。</li>
</ol>

<p>为解决上述问题，作者提出通过训练user_type和listing_type的embedding来取代user_id和listing_id的embedding。type是通过一系列人工规则来将不同的id映射到不同的type：</p>

<p><img src="https://jasonyanglu.github.io/images/2019-07-02-blog-post-5.assets/2.png" alt="" /></p>

<p>对于新用户，先用其画像属性来分type，待其有了消费记录后，用其最近一次消费过后的type来作为该用户的user_type。</p>

<h3 id="训练过程">训练过程</h3>

<p>对于历史消费记录，训练embedding的一个session表示为$s_b=(u_{type_1}l_{type_1}, …, u_{type_M}l_{type_M})$，$u_{type_1}l_{type_1}$代表用户第1次消费记录时的user_type和当时订的listing的listing_type。user_type和listing_type在同一个向量空间中被训练。中心被训练的item可以是user_type也可以是listing_type</p>

<p><img src="https://jasonyanglu.github.io/images/2019-07-02-blog-post-5.assets/3.png" alt="" /></p>

<h3 id="拒绝租客作为显示负样本">拒绝租客作为显示负样本</h3>

<p>如果一个用户下订单之后被房东拒绝了，那么这个listing会被看做是一个显式的负样本，这个负样本将被放进训练窗口中。</p>

<p><img src="https://jasonyanglu.github.io/images/2019-07-02-blog-post-5.assets/4.png" alt="" /></p>

<h2 id="experiment">Experiment</h2>

<ul>
  <li>模型采用的是GBDT回归，特征由4部分组成：listing特征，用户特征，请求特征，交叉特征。样本的标签定义如下：
    <ul>
      <li>0：曝光未点击。</li>
      <li>1：成功预定。</li>
      <li>0.25：用户联系了房东，但是最终没预定。</li>
      <li>0.01：点击。</li>
      <li>-0.4：用户被房东拒绝。</li>
    </ul>
  </li>
  <li>除了一些基础画像特征和统计特征，文章使用了用户最近2周的行为特征，将listing id分成了6个组
    <ol>
      <li>点过的listing。</li>
      <li>点过并且在页面停留了60秒以上的listing。</li>
      <li>曝光了但是被跳过的listing。</li>
      <li>收藏的listing。</li>
      <li>联系过房东但是没订的listing。</li>
      <li>订了的listing。</li>
    </ol>
  </li>
  <li>一个用户的这些组的listing的embedding计算均值之后作为用户的embedding，与被推荐的listing embedding计算cosine距离后，作为一个特征丢进模型。除了以上6个特征以外，还有2个特征：
    <ol>
      <li>最近一次点过并且在页面停留了60秒以上的listing和被推荐listing的距离。</li>
      <li>user_type和listing_type的距离。</li>
    </ol>
  </li>
</ul>

<h2 id="qa">Q&amp;A</h2>

<ol>
  <li>
    <p>Real-time体现在什么地方？</p>

    <p>用户当前点击的listing的向量来计算listing embedding features，从而加入特征进行实时的推荐。 也就是说，t时刻的推荐结果，是根据用户在t时刻之前的行为生成的特征。 在t+1时刻如果用户点击了另外一个listing,  listing embedding features也会随之发生变化，推荐的结果也就可能变化。</p>
  </li>
  <li>
    <p>实际业务中怎么用listing embedding，listing type embedding和user type embedding？</p>

    <p>最后所有的embedding都没有直接放入模型，取而代之的是将各种embedding之间的cosine距离作为特征丢给模型训练。实验部分说明了，最后训练出的embedding只是在原有的GBDT模型上，加了8维cosine距离的特征，加完之后共104维特征，结论是embedding特征的feature importance比较高。</p>
  </li>
  <li>
    <p>为什么不用点击率作为排序目标？</p>

    <p>Airbnb的最终目标是用户是否下订，点击不下订和曝光不点击对于业务指标并没有太多区别（但是对训练listing embedding很重要），这一点从文章的回归任务中的曝光不点击的label是0，而点击不下订的label是0.01就可以看出。</p>
  </li>
  <li>
    <p>listing embedding已经有了30min作为session分隔，为什么还需要sliding window？</p>

    <p>文中提到的sliding window应该指的是在一个session内，从第一个listing开始作为中心，逐渐往右边移动选择下一个作为中心，和skip-gram的window是对应的。</p>
  </li>
</ol>

<h2 id="参考">参考</h2>

<p>https://zhuanlan.zhihu.com/p/43295545</p>

<p>感谢腾讯高级研究员陈亮与本人共同完成此文。</p>]]></content><author><name>Yang Lu (卢杨)</name><email>luyang@xmu.edu.cn</email></author><category term="Embedding" /><category term="Attention" /><category term="论文解读" /><summary type="html"><![CDATA[这篇文章是airbnb提出的一种构造item embedding的方式。该方法将应用领域的需求与算法高度结合。]]></summary></entry><entry><title type="html">Deep Reinforcement Learning: Pong from Pixels学习笔记</title><link href="https://jasonyanglu.github.io/posts/2019/07/blog-post-1/" rel="alternate" type="text/html" title="Deep Reinforcement Learning: Pong from Pixels学习笔记" /><published>2019-07-01T00:00:00-07:00</published><updated>2019-07-01T00:00:00-07:00</updated><id>https://jasonyanglu.github.io/posts/2019/07/blog-post-1</id><content type="html" xml:base="https://jasonyanglu.github.io/posts/2019/07/blog-post-1/"><![CDATA[<p>Deep Reinforcement Learning: Pong from Pixels是一篇很好的强化学习入门博文。其中详细介绍了DRL一种常用的方法：Policy Gradient。原文链接：http://karpathy.github.io/2016/05/31/rl/</p>

<h1 id="乒乓球游戏">乒乓球游戏</h1>

<p>乒乓球游戏是一个最简单的也是最好的例子来说明如何强化学习方法是如何工作的。这个游戏玩家可以通过上下移动球拍来接球，成功接到球+1分，没接到-1分。</p>

<p><img src="http://karpathy.github.io/assets/rl/pong.gif" alt="" /></p>

<p>对于我们的算法来说，这个游戏的输入就是每一帧的全局像素（210*160*3），输出则是向上移动还是向下移动球拍。</p>

<h2 id="策略网络">策略网络</h2>

<p>策略网络就是一个普通的前馈神经网络，输入是把像素矩阵拉平之后的向量，通过权重W1，W2，以及激活函数，最终输出行为的概率，例如向上40%，向下60%。得到行为的概率之后，通过采样决定下一步采用哪个行为，之后再通过这个行为的reward来更新策略网络的参数。代码很简单：</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">h</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">dot</span><span class="p">(</span><span class="n">W1</span><span class="p">,</span> <span class="n">x</span><span class="p">)</span> <span class="c1"># compute hidden layer neuron activations
</span><span class="n">h</span><span class="p">[</span><span class="n">h</span><span class="o">&lt;</span><span class="mi">0</span><span class="p">]</span> <span class="o">=</span> <span class="mi">0</span> <span class="c1"># ReLU nonlinearity: threshold at zero
</span><span class="n">logp</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">dot</span><span class="p">(</span><span class="n">W2</span><span class="p">,</span> <span class="n">h</span><span class="p">)</span> <span class="c1"># compute log probability of going up
</span><span class="n">p</span> <span class="o">=</span> <span class="mf">1.0</span> <span class="o">/</span> <span class="p">(</span><span class="mf">1.0</span> <span class="o">+</span> <span class="n">np</span><span class="p">.</span><span class="n">exp</span><span class="p">(</span><span class="o">-</span><span class="n">logp</span><span class="p">))</span> <span class="c1"># sigmoid function (gives probability of going up)
</span></code></pre></div></div>

<p>一句话描述Policy gradient: 使用一种policy跑一会儿，然后看看这种policy下的哪种行为会得到高分，然偶增加这种行为的概率。</p>

<h2 id="训练模型">训练模型</h2>

<p>将W1，W2随机初始化，进行100次乒乓球游戏。假设每次游戏有200帧，那么就将得到2万次行为决策。假如最终我们赢了12次，输了88次，2万次里面的2400次决策就会使用正反馈对网络进行更新，另外17600次决策就会用负反馈对网络进行更新。更新之后如果再进行100次游戏，则决策就会向赢的概率大的方向移动。</p>

<h2 id="与有监督学习的关系">与有监督学习的关系</h2>

<p>其实PG与有监督学习非常类似，只有2个细微的差别。</p>

<ol>
  <li>有监督学习在得到logit并softmax之后，可以通过和真实标签计算交叉熵得到loss再计算梯度以及使用反向传播更新神经网络。然而在PG的学习过程中，我们并没有真实标签y，softmax之后得到的是产生每个action的概率，例如向上移动0.7，向下移动0.3。由于没有标签，只能通过对action的概率进行采样，采样到的action就是它的标签，所以PG的标签可以称为“假标签”。</li>
  <li>采样得到的action应用到环境中，然后通过环境给出的reward来计算梯度。所以PG的loss计算其实就是$A_i\log p(y_i\rvert x_i)$，$A_i$是在当前环境$x_i$下通过policy $p(x)$采样得到的行为$y_i$。因为一个step只能有一个action，所以softmax的其他项都是0（我们不可能在当前step计算每个action的$A_i$）。</li>
</ol>

<h2 id="折扣reward">折扣Reward</h2>

<p>一个回合中，每个step都希望考虑除了本身的reward，还加上一些未来的reward，但是离当前step越远的reward的权重就越低。这样做使得早期的action与最终一个episode的结局reward有了联系，尤其是在一些场景中，每个step没有即时的reward，只有当一个episode结束后才能知道这一系列action将得到多少reward。</p>

\[R_t=\sum_{k=0}^\inf \gamma^kr_{t+k}=r_t + \gamma r_{t+1} + \gamma^2 r_{t+2} + \gamma^3 r_{t+3} +...\]

<h2 id="pg的数学推导">PG的数学推导</h2>

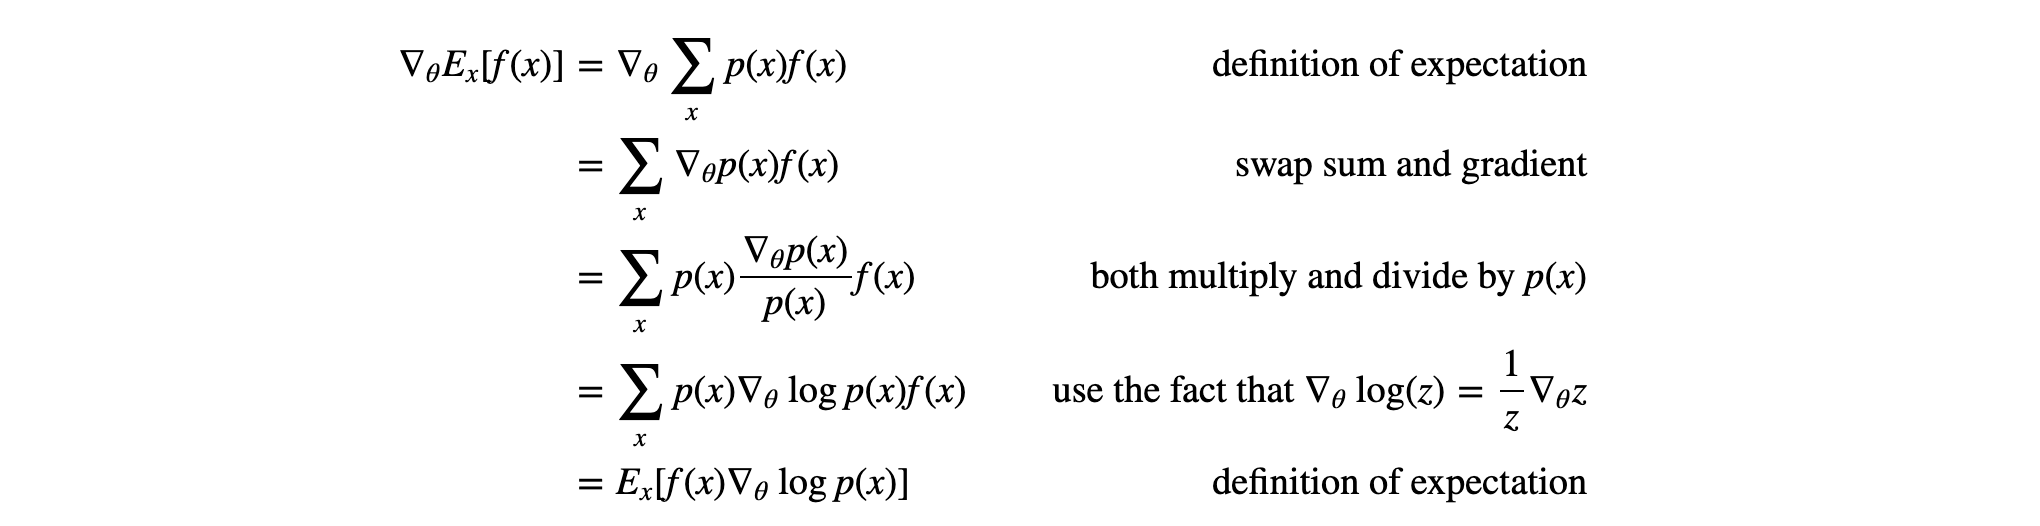
<p>PG的loss，或者说是最终得分其实很简单，就是$E_{x\sim p(x\rvert\theta)}[f(x)]$，就是在当前policy $p(x)$下的得分$f(x)$的期望。所以我们需要计算的就是得分期望的梯度$\nabla_\theta E_{x\sim p(x\rvert\theta)}[f(x)]$。推导如下：</p>

<p><img src="https://jasonyanglu.github.io/images/2019-07-01-blog-post-1.assets/image-20190701112717103.png" alt="" /></p>

<p>其实本质上就是如何将求梯度从期望外移进去，并且再写成期望的形式的一个过程。从最后公式推导最后一行可以看出，最终的形式是每一步的概率求log之后计算梯度，再乘上对应的得分，最后再求均值。</p>

<h1 id="一些思考">一些思考</h1>

<p>对于人类来说，你只要跟他说清楚这个游戏的规则，那么他大概就可以上手玩了，并不需要学习。人类和RL学习玩游戏有几个不同或相同之处：</p>

<ol>
  <li>RL不接受任何规则输入，完全凭空通过试错去猜测游戏的模式。从这个角度来看，如果不跟人类说游戏规则，让人通过试错去猜测游戏玩法，那么RL会比人强很多。尤其是如果把屏幕上的像素位置全部打乱，人类根本无法通过视觉学会游戏规则，而RL可以轻易通过全连接的神经网络学会。</li>
  <li>人类带有大量的先验知识。例如球会反弹，弹出的角度与弹入的角度是一样的，方向键对应着球拍的移动，等等。然而RL什么都不知道，全凭摸索。</li>
  <li>PG其实是一种暴力搜索的方法，尝试每个动作，然后把好的动作记下来。然而人类在学习新东西的时候，也会潜意识地将正确的行为变成肌肉记忆。例如骑车或游泳，一开始的时候会遍做遍想该怎么做，熟练（不停试错并且有正反馈）之后，则不需要思考，单靠肌肉记忆就可以完成。</li>
  <li>试错是RL学习的必要条件，然而不是人类学习的必要条件。还是由于先验知识，人类可以在不经历任何反馈的情况下，做出正确的行为。例如，人类不需要真实经历撞车几百次，才能学会如何避免撞车。先验知识决定了人类可以迅速将游戏规则（策略网络）高度抽象化（用一句话来描述游戏规则）。</li>
</ol>]]></content><author><name>Yang Lu (卢杨)</name><email>luyang@xmu.edu.cn</email></author><category term="强化学习" /><category term="学习笔记" /><summary type="html"><![CDATA[Deep Reinforcement Learning: Pong from Pixels是一篇很好的强化学习入门博文。其中详细介绍了DRL一种常用的方法：Policy Gradient。原文链接：http://karpathy.github.io/2016/05/31/rl/]]></summary></entry><entry><title type="html">机器学习业务评估统计方法</title><link href="https://jasonyanglu.github.io/posts/2019/07/blog-post-2/" rel="alternate" type="text/html" title="机器学习业务评估统计方法" /><published>2019-07-01T00:00:00-07:00</published><updated>2019-07-01T00:00:00-07:00</updated><id>https://jasonyanglu.github.io/posts/2019/07/blog-post-2</id><content type="html" xml:base="https://jasonyanglu.github.io/posts/2019/07/blog-post-2/"><![CDATA[<p>工业界机器学习模型常需围绕<strong>业务</strong>展开，除了机器学习本身的模型评估指标外（如LogLoss、AUC、KL等），还需要针对业务目标进行相关统计信息评估，完成针对部分流量样本上线模型后的效果分析。例如，一个模型上线后因灰度测试考虑往往先分配较少流量，当讨论测试结果是否显著用以衡量新模型有效性时，就需要使用统计评估方法。本文汇总一些常用统计方法，用于分析统计量之间的关系。</p>

<h1 id="假设检验目标与流程">假设检验目标与流程</h1>

<p>假设检验是事先对<strong>总体（随机变量）的参数</strong>或<strong>总体分布</strong>形式做出一个假设，然后利用<strong>样本信息</strong>来判断这个假设是否合理。 例如，赵先生开了一家日用百货公司，该公司分别在郑州和杭州开设了分公司。现在存在下列数据作为两个分公司的销售额，集合中的每一个数代表着一年中某一个月的公司销售额。</p>

<center>
郑州分公司 = {23,25,26,27,23,24,22,23,25,29,30}<br />
杭州分公司 = {24,25,23,26,27,25,25,28,30,31,29}
</center>

<p>现在，赵先生想要知道两个公司的月销售额是否有存在明显的差异，即是否存在郑州分公司月销售额高于杭州分公司月销售额，抑或反之。</p>

<p>在这个问题中，总体分布是郑州分公司月销售额和杭州分公司月销售额（理论上来说，总体分布永远无法得知，只能不断通过样本信息来逼近），样本信息是两个公司某11个月每个月的销售额。我们需要通过假设检验来利用样本信息推出总体分布之间的关系。我们可以提出零假设（null hypothesis）</p>

\[H_0=两个分公司月销售额相等\]

<p>和备择假设（alternative hypothesis）</p>

\[H_1=两个分公司月销售不相等\]

<p>通过假设检验，我们通常可以得出一个与某分布相关的统计量，例如Z统计量，T统计量，$\chi^2$统计量。之后可以通过统计量在其分布中的位置计算得出一个p值。p值代表 $H_0$ 会发生的概率，如果p值很小，说明 $H_0$ 会发生的概率很小，拒绝 $H_0$ 基本不会错，所以可以接受 $H_1$。上例中，杭州分公司的均值虽然大于郑州分公司的均值，但是p值=0.2027，通常p值小于0.05代表有显著性差异，所以我们无法拒绝 $H_0$（即使得到的p值很大，最后的结论也不能接受 $H_0$，因为统计检验的目标是拒绝 $H_0$ 而不是接受，所以结论只有有显著差异和无显著差异，并不能得出两个总体相等的结论） 。所以上例的结论是郑州分公司和杭州分公司的月销售额无显著性差异。</p>

<h1 id="t检验">T检验</h1>

<h2 id="单样本-single-sample">单样本 (single sample)</h2>

<p>单样本T检验是检验单个样本平均数 $\bar{x}$ 与一个指定的常数 $\mu_0$ （一个已知的总体平均数）差异是否显著。<strong>当总体分布是正态分布，如总体标准差未知且样本容量小于30</strong>，那么样本平均数与总体平均数的离差统计量呈t分布。</p>

<ul>
  <li>
    <p><strong>条件</strong>：数据类型是连续值。已知样本平均数及样本标准差，样本来自正态或近似正态总体 ，通常样本含量较小（例如 $n&lt;30$） 。</p>
  </li>
  <li>
    <p><strong>优点</strong>：容易获取全部需要计算的信息。</p>
  </li>
  <li>
    <p><strong>缺点</strong>：如果满足Z检验的条件时，T检验的准确度低于Z检验。</p>
  </li>
  <li>
    <p><strong>举例</strong>：</p>

    <ul>
      <li>检验一组学生的平均 IQ 得分是否不等于100。</li>
      <li>某校二年级学生期中英语考试成绩，其平均分数为73分，标准差为17分，期末英语考试后，随机抽取20人的英语成绩，其平均分数为79.2分。问二年级学生的英语成绩是否有显著性进步？</li>
    </ul>
  </li>
  <li>
    <p><strong>计算</strong>：</p>

    <p>检验零假设 $H_0 : \mu =\mu_0$ 可利用以下统计量</p>

\[t=\frac{\bar{x}-\mu_0}{s/\sqrt{n}}\]

    <p>其中</p>

\[s=\sqrt{\frac{\sum_{i=1}^n(x_i-\bar{x})^2}{n-1}}\]

    <p>为样本标准偏差。该统计量t在零假设 $H_0 : \mu =\mu_0 $为真的条件下服从自由度为 $v=n − 1$ 的t分布。计算出t值之后，根据显著度 $\alpha$，自由度 $v$ ，可查t表得出结果。例如通过计算得出t值为2.5，样本数为10，显著度为0.05，通过查表可得临界t值为2.262，小于t值，所以可以拒绝零假设，得出结论 $\bar{x}$ 与 $\mu_0$ 存在显著差异。</p>
  </li>
  <li>
    <p><strong>业务案例</strong>：</p>

    <p>假设现在业务需要衡量一款产品的用户体验。用户体验这个概念比较主观，我们需要将定性的数据进行定量化处理。我们将一般的用户体验分为以下5种：</p>

    <ol>
      <li><strong>感官体验：</strong>呈现给用户视听上的体验，强调舒适性。</li>
      <li><strong>交互体验：</strong>呈现给用户操作上的体验，强调易用/可用性。</li>
      <li><strong>情感体验：</strong>呈现给用户心理上的体验，强调友好性。</li>
      <li><strong>浏览体验：</strong>呈现给用户浏览上的体验，强调吸引性。</li>
      <li><strong>信任体验：</strong>呈现给用户的信任体验，强调可靠性。</li>
    </ol>

    <p>我们针对每一种体验分别给予0-10，10个评分等级，针对每种体验给予自己主观的打分，之后算出五个分数的平均得分。例如我们的一个目标用户的体验得分如下：</p>

    <table>
      <thead>
        <tr>
          <th style="text-align: left"> </th>
          <th>分数段</th>
          <th>得分</th>
        </tr>
      </thead>
      <tbody>
        <tr>
          <td style="text-align: left">感官体验</td>
          <td>0-10</td>
          <td>4</td>
        </tr>
        <tr>
          <td style="text-align: left">交互体验</td>
          <td>0-10</td>
          <td>7</td>
        </tr>
        <tr>
          <td style="text-align: left">浏览体验</td>
          <td>0-10</td>
          <td>6</td>
        </tr>
        <tr>
          <td style="text-align: left">情感体验</td>
          <td>0-10</td>
          <td>7</td>
        </tr>
        <tr>
          <td style="text-align: left">信任体验</td>
          <td>0-10</td>
          <td>8</td>
        </tr>
        <tr>
          <td style="text-align: left">平均得分</td>
          <td>0-10</td>
          <td><strong>6.4</strong></td>
        </tr>
      </tbody>
    </table>

    <p>我们邀请28个目标用户，事先与其沟通好每种体验的正确体验方式，得出了28人的体验平均得分样本：</p>

    <p>6.2，5.3，8.7，7.4，5.2，6.9，8.3，4.4，7.8，6.5，5.9，5.3，5.4，7.5，7.4，4.3，8.5，6.9，6.4，4.7，8.7，6.4，9.2，6.3，4.7，6.5，5.4，7.1</p>

    <p>我们假设用户体验的行业及格平均分的标准为6分。那么，我们提出的问题是，此产品的用户体验平均得分是否显著超过行业及格标准分?</p>

    <p>我们假设用户体验得分服从正态分布，并且每个用户的体验得分相互独立。由于样本数量不足30且服从正态分布，满足使用单样本T检验的条件。在此问题中，零假设 $H_0$ 和备择假设 $H_1$ 分别为：</p>

\[H_0: \mu =\mu_0\\H_1: \mu &gt;\mu_0\]

    <p>其中 $\mu$ 是总体用户体验得分，$\mu_0$ 是行业及格标准分。通过样本，我们可以得到 $\bar{x}=6.54$，$\mu_0=6$，$n=28$，通过上式可以计算得出 $s=1.3927$，$t=2.0517$。因为我们确信样本均值大于行业及格标准分，所以该检验问题为单侧检验。由于样本数 $n=28$，自由度 $v=n−1=27$ ，通过查询t表找到 $v=27$ 时显著水平 $\alpha=0.05$ 的t值临界值为1.703。由于计算得出t值大于t临界值，我们拒绝 $H_0$，我们可以判断此产品的样本用户体验得分显著大于行业及格标准分。</p>

    <p>（案例数据来源：http://www.woshipm.com/pmd/721338.html）</p>
  </li>
</ul>

<h2 id="双样本-two-sample">双样本 (two sample)</h2>

<p>双样本T检验是检验两个样本平均数 $\bar{x}_1$ 和 $\bar{x}_2$与其各自所代表的总体的差异是否显著。双总体T检验是检验两个样本平均数与其各自所代表的总体的差异是否显著。</p>

<ul>
  <li>
    <p><strong>条件</strong>：数据类型是连续值。已知两个样本的个数，样本均值，以及样本标准差。</p>
  </li>
  <li>
    <p><strong>优点</strong>：比较两组样本最简单的统计检验。</p>
  </li>
  <li>
    <p><strong>缺点</strong>：样本要求独立同分布，在样本数量少并且不能够严格满足条件时，可能会出现type-I和type-II错误。</p>
  </li>
  <li>
    <p><strong>举例</strong>：在小学三年级学生中随机抽取10名学生，在学期初和学期末分别进行了两次推理能力测验，成绩分别为79.5和72分，标准差分别为9.124，9.940。问两次测验成绩是否有显著地差异？</p>
  </li>
  <li>
    <p><strong>计算</strong>：
检验零假设 $H_0 : \mu_1 =\mu_2 $ 可利用以下统计量</p>

\[t=\frac{\bar{x}_2-\bar{x}_1}{\sqrt{\frac{s_1^2}{n_1}+\frac{s_2^2}{n_2}}}\]

    <p>其中 $s_1$ 和 $s_2$ 为样本标准差，该统计量t在零假设 $H_0 : \mu =\mu_0 $为真的条件下服从自由度为 $v=n_1+n_2 − 2$ 的t分布。计算出t值之后，根据显著度 $\alpha$，自由度 $v$ ，可查t表得出结果。</p>
  </li>
  <li>
    <p><strong>业务案例</strong>：</p>

    <p>场景同上例，现在这款产品的某个组件得到根据一些用户反馈做了调整。我们又邀请到了22个目标用户，得出了22人在产品更新之后的体验平均得分样本：</p>

    <p>8.2，5.5，4.7，7.4，6.2，6.3，4.3，6.4，7.5，8.5，5.4，6.3，5.6，5.5，7.4，4.7，8.2，4.9，5.4，4.6，8.3，6.6，9.2，6.3</p>

    <p>现在我们提出的问题是，产品更新之后的用户体验平均得分是否与更新之前有所区别？</p>

    <p>该问题中，零假设 $H_0$ 和备择假设 $H_1$ 分别为：</p>

\[H_0: \mu_1 =\mu_2\\H_1: \mu_1 \ne \mu_2\]

    <p>其中 $\mu_1$ 是产品更新之前的总体用户体验得分，$\mu_2$ 是产品更新之后的总体用户体验得分。通过样本，我们可以得到 $\bar{x}_1=6.54$，$\bar{x}_2=6.39$，$n_1=28$，$n_2=22$，通过上式可以计算得出 $s_1=1.3927$，$s_2=1.4735$，$t=0.3717$。因为我们想要检验更新之后的产品带来什么影响，并不确定这个影响会提升用户体验得分还是降低，所以该检验问题为双侧检验。由于样本数 $n_1=28$，$n_2=22$，自由度 $v=n_1+n_2−2=48$ 。我们的问题是判断通过查询t表找到 $v=48$ 时显著水平 $\alpha=0.05$ 的t值临界值为2.01。由于计算得出t值小于t值临界值，无法拒绝 $H_0$，最后的结论是产品更新之后与之前无显著差异（多么悲伤的结果）。</p>
  </li>
</ul>

<h1 id="z检验">Z检验</h1>

<h2 id="单样本">单样本</h2>

<p>单样本Z检验是检验一个样本平均数 $\bar{x}$ 与一个已知的总体平均数 $\mu_0$ 的差异是否显著。</p>

<ul>
  <li>
    <p><strong>条件</strong>：数据类型是连续值。需要知道这个对比总体的总体平均数 $\mu_0$ 和总体标准差 $\sigma_0$ 。</p>
  </li>
  <li>
    <p><strong>优点</strong>：简单且精确。</p>
  </li>
  <li>
    <p><strong>缺点</strong>：需要知道总体标准差 $\sigma_0$ ，多数情况 $\sigma_0$ 永远无法得知，但是在样本数量很大时可以用样本标准差代替总体标准差。</p>
  </li>
  <li>
    <p><strong>举例</strong>：</p>

    <ul>
      <li>某班级的平均智商为114。全中国的平均智商是100，标准差为15。那么这个班级的平均智商是否显著高于全国平均智商？</li>
      <li>根据1983年大量调查结果，已知某地成年男子的脉搏均数为72次/分钟。某医生2003年在该地区随机调查了100名成年健康男子，求得其脉搏均数为74.2次/分钟，标准差为6.5次/分钟，能否根据此认为该成年男子的脉搏数不同于1983年？</li>
    </ul>
  </li>
  <li>
    <p><strong>计算</strong>：</p>

    <p>检验零假设 $H_0 : \mu =\mu_0$ 可利用以下统计量</p>

\[z=\frac{\bar{x}-\mu_0}{\sigma/\sqrt{n}}\]

    <p>得到z统计量之后可以通过查t表中自由度最后一栏（通常标注为 $\infty$ 或 $z$），或者直接查z表（又称标准正太分布表），得出相应的p值。</p>
  </li>
  <li>
    <p><strong>业务案例</strong>：</p>

    <p>某游戏产品上线前根据问卷调查得出用户预期的平均游戏时长为每周10小时。在游戏上线后，根于50000样本用户统计得出一周内平均游戏时长为10.5小时，标准差为6。则该数据是否显著高于问卷得出的预期游戏时长？</p>

    <p>在此问题中，零假设 $H_0$ 和备择假设 $H_1$ 分别为：</p>

\[H_0: \mu =\mu_0\\H_1: \mu &gt; \mu_0\]

    <p>其中 $\mu$ 是总体用户每周平均游戏时长，$\mu_0$ 是预期的平均游戏时长。通过样本，我们可以得到 $\bar{x}=10.5$，$\mu_0=10$，$\sigma=6$，$n=50000$，通过上式可以计算得出 $z=18.6339$。通过查表，可得 $z&gt;18.6339$ 时的正态分布累计概率密度趋近于0。由于该问题是单侧检验，最后得到的p值就为0。所以结论为拒绝 $H_0$, 游戏产品上线后用户每周平均游戏时长显著高于预期。</p>
  </li>
</ul>

<h2 id="双样本">双样本</h2>

<p>双样本Z检验是检验两个已知的总体平均数 $\mu_1$ 与 $\mu_2$ 的差异是否显著。检验来自两个的两组样本平均数的差异性，从而判断它们各自代表的总体的差异是否显著。</p>

<ul>
  <li>
    <p><strong>条件</strong>：数据类型是连续值。需要知道两个总体的标准差 $\sigma_1$ 和 $\sigma_2$ 。或者在样本数量大的时候用样本标准差 $s_1$ 和 $s_2$ 近似。</p>
  </li>
  <li>
    <p><strong>优点</strong>：简单且精确。</p>
  </li>
  <li>
    <p><strong>缺点</strong>：需要知道总体标准差 $\sigma_1$ 和 $\sigma_2$ 。</p>
  </li>
  <li>
    <p><strong>举例</strong>：</p>

    <ul>
      <li>
        <p>已知在男性献血者的血液中某种微量元素的数量变化的标准差为14.1ppm，女性为9.5ppm。现在有75名随机男性样本和50名随机女性样本的平均数为28和33ppm。则男性和女性血液中某种微量元素的数量是否有显著差异？</p>
      </li>
      <li>
        <p>研究正常人与高血压患者胆固醇含量的资料如下，试比较两组血清胆固醇含量有无差别。</p>

        <p>正常人组：n=506,x=180.6,s=34.2</p>

        <p>高血压组：n=142,x=223.6,s=45.8</p>
      </li>
    </ul>
  </li>
  <li>
    <p><strong>计算</strong>：</p>

    <p>检验零假设 $H_0 : \mu_1 =\mu_2 $ 可利用以下统计量</p>

\[z=\frac{\bar{x}_2-\bar{x}_1}{\sqrt{\frac{\sigma_1^2}{n_1}+\frac{\sigma_2^2}{n_2}}}\]

    <p>得到z统计量之后可以通过查t表中自由度最后一栏（通常标注为 $\infty$ 或 $z$），或者直接查z表（又称标准正太分布表），得出相应的p值。</p>
  </li>
  <li>
    <p><strong>业务案例</strong>：</p>

    <p>场景同上例，该游戏产品上线了一个新模块，想测试该模块是否会影响用户的每周平均游戏时长，于是将用户流量分成对照组和改进组，改进组上线新模块，对照组不上线。对照组和改进组分别有50000用户。对照组在一周内的平均游戏时长为10.5小时，标准差为6，改进组在一周内的平均游戏时长为10.6小时，标准差为8。则这个新模块与没上线之前是否对用户每周平均时长产生影响？</p>

    <p>在此问题中，零假设 $H_0$ 和备择假设 $H_1$ 分别为：</p>

\[H_0: \mu_1 =\mu_2\\H_1: \mu_1 \ne \mu_2\]

    <p>其中 $\mu_1$ 是上线新模块的每周平均游戏时长，$\mu_2$ 是没上线新模块的每周平均游戏时长。通过样本，我们可以得到 $\bar{x}_1=10.5$，$\bar{x}_2=10.6$，$\sigma_1=6$，$\sigma_2=8$，$n_1=n_2=50000$，通过上式可以计算得出 $z=2.2360$。通过查表，可得 $z&gt;2.2360$ 时的正态分布累计概率密度为0.0125。由于该问题是双侧检验，最后得到的p值为 $0.0125\times2=0.025$ 。所以结论为拒绝 $H_0$, 新模块上线后，用户一周平均游戏时长有提升，且与不上线有显著差异。</p>
  </li>
</ul>

<h2 id="单比例">单比例</h2>

<p>单比例Z检验是检验一个样本中服从二项分布的个体出现或事件发生的比例，是否与一个给定的比例有显著差异。</p>

<ul>
  <li>
    <p><strong>条件</strong>：数据类型是二项的（Bernoulli 数据）。需要知道个体出现的次数 $x$ 或者个体出现的比例 $\bar{p}$ （$\bar{p}=x/n$），样本个数 $n$，以及一个给定的比例 $p_0$。</p>
  </li>
  <li>
    <p><strong>优点</strong>：简单且精确。</p>
  </li>
  <li>
    <p><strong>缺点</strong>：假设个体出现是独立同分布的。独立指的是每个个体出现的概率不受其他个体影响，同分布指的是每个个体根据一个固定潜在的概率出现。但是独立同分布往往很难严格满足。</p>
  </li>
  <li>
    <p><strong>举例</strong>：政府决定扶持员工少数民族占比超过15%的公司。一家公司共73人，其中13人是少数民族。则该公司员工少数民族占比是否显著超过政府规定的15%？</p>
  </li>
  <li>
    <p><strong>计算</strong>：</p>

    <p>检验零假设 $H_0 : p =p_0 $ 可利用以下统计量</p>

\[z=\frac{\bar{p}-p_0}{\sqrt{\frac{p_0(1-p_0)}{n}}}\]

    <p>得到z统计量之后可以通过查t表中自由度最后一栏（通常标注为 $\infty$ 或 $z$），或者直接查z表（又称标准正太分布表），得出相应的p值。</p>
  </li>
  <li>
    <p><strong>业务案例</strong>：</p>

    <p>一个推荐系统上线前的预期点击转化率为50%。上线后，曝光用户数为10000，其中5100个用户点击了推荐物品，真实点击转化率为51%，高于预期的50%。但是在曝光用户数为10000的量级上，高于预期1%是否能够说明真实和预期点击转化率有显著差异呢？</p>

    <p>在此问题中，零假设 $H_0$ 和备择假设 $H_1$ 分别为：</p>

\[H_0: p =p_0\\H_1: p &gt; p_0\]

    <p>其中 $p$ 是该系统总体点击转化率，$p_0$ 是预期点击转化率。通过样本，我们可以得出 $\bar{p}=0.51$，$p_0=0.5$，$n=10000$，通过上式可以计算得出 $z=2$。通过查表，可得 $z&gt;2$ 时的正态分布累计概率密度为0.0228。由于该问题是单侧检验，最后得到的p值就为0.0228。由于该p值小于0.05，所以可以得出结论，拒绝 $H_0$，真实点击转化率与预期点击转化率有显著差异。</p>

    <p>同一个问题，如果把量级缩小10倍，曝光用户数为1000，其中510个用户点击了推荐物品，那么是否依然存在显著差异呢？在上式中，$p_0$ 和 $\bar{p}$ 都没有改变，只有 $n$ 变小了。通过计算得出 $z=0.6324$，查表得出p值为0.2643，无法拒绝 $H_0$。所以在 $n=1000$ 时，51%的转化率与50%无显著差异。</p>
  </li>
</ul>

<h2 id="双比例">双比例</h2>

<p>单比例Z检验是检验两组样本中服从二项分布的个体出现或事件发生的比例是否有显著差异。</p>

<ul>
  <li>
    <p><strong>条件</strong>：数据类型是二项的（Bernoulli 数据）。需要知道个体出现的次数 $x_1$ 和 $x_2$ 或者个体出现的比例 $\bar{p}_1$ 和 $\bar{p}_2$ （$\bar{p}=x/n$），样本个数 $n_1$ 和 $n_2$。</p>
  </li>
  <li>
    <p><strong>优点</strong>：简单且精确。</p>
  </li>
  <li>
    <p><strong>缺点</strong>：假设个体出现是独立同分布的。独立指的是每个个体出现的概率不受其他个体影响，同分布指的是每个个体根据一个固定潜在的概率出现。但是独立同分布往往很难严格满足。</p>
  </li>
  <li>
    <p><strong>举例</strong>：在一次政治票选中，46%的男性和49%的女性声称他们支持特朗普称为总统。如果该次统计当中包含247名男性和185名女性，那么男性和女性对于特朗普的支持率是否有显著差异？</p>
  </li>
  <li>
    <p><strong>计算</strong>：</p>

    <p>检验零假设 $H_0 : p_1 =p_2 $ 可利用以下统计量</p>

\[z=\frac{\bar{p}_2-\bar{p}_1}{\sqrt{\bar{p}\bar{q}(\frac{1}{n_1}+\frac{1}{n_2})}}\]

    <p>其中</p>

\[\bar{p} = \frac{n_1\bar{p}_1+n_2\bar{p}_2}{n_1+n_2}\]

    <p>得到z统计量之后可以通过查t表中自由度最后一栏（通常标注为 $\infty$ 或 $z$），或者直接查z表（又称标准正太分布表），得出相应的p值。</p>
  </li>
  <li>
    <p><strong>业务案例</strong>：</p>

    <p>一个推荐系统有新旧2个模型，分别占用50%的流量。两个模型的曝光用户数分别为10000和10500，且分别有5000和5100个用户点击了推荐物品，则两个模型的点击转化率是否有显著区别？</p>

    <p>在此问题中，零假设 $H_0$ 和备择假设 $H_1$ 分别为：</p>

\[H_0: p_1 =p_2\\H_1: p_1 \ne p_2\]

    <p>其中 $p_1$ 是新模型点击转化率，$p_2$ 是旧模型点击转化率。通过样本，我们可以得出 $\bar{p}_1=0.5$，$\bar{p_2} = 0.4857$，$n_1=10000$，$n_2=10500$。z值可以计算得出为2.0450。通过查表，可得 $z&gt;2.0450$ 时的正态分布累计概率密度为0.0205。由于该问题是双侧检验，最后得到的p值为 $0.0205\times 2=0.041$。由于该p值小于0.05，所以可以得出结论拒绝 $H_0$，新旧两个模型存在显著差异。</p>
  </li>
</ul>

<h1 id="思考">思考</h1>

<h2 id="何时t检验何时z检验">何时T检验？何时Z检验？</h2>

<p>用什么检验的理论依据是中心极限定理。根据中心极限定理，如果能够满足简单随机抽样具备30个样本容量，那么样本平均数的抽样分布就是近似正态概率分布（无论样本总体服从什么分布，只要是独立同分布都可以）。如果已知总体是正态分布，则不管简单随机抽样的样本是多少，样本均值的抽样分布都服从正态分布。因此在决定用什么检验的时候，需要考虑三个因素：是否已知总体标准差，样本数有多少，样本是否服从正态分布，然后根据下列规则进行判断：</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>if 已知总体标准差：
    用Z检验
else：
    if 样本数&gt;30：
	    用样本标准差去估计总体标准差，然后用Z检验
	else：
		if 样本服从正态分布：
			用T检验
		else：
			跟参数检验无缘了，用非参数检验吧
</code></pre></div></div>

<p>用什么检验，依据的是中心极限定理。中心极限定理中说，如果能够满足简单随机抽样具备30个样本容量，那么样本均值的抽样分布就是近似正态概率分布（注意不管总体服从什么分布）；如果总体是正态概率分布的，不管简单随机抽样的样本是多少，样本均值的抽样分布都是正态概率分布。因此在你决定用什么检验的时候，首要考虑的条件是样本量，其次是总体是服从什么分布，然后因为样本均值的标准误（即样本均值抽样分布的标准差）的公式中需要知道总体的标准差，如果总体标准差知道，（无论大小样本，只是如果是小样本须满足总体要近似正态概率分布）都用Z检验；如果是大样本（n大于等于30），并且总体标准差未知，要用样本标准差去估计总体标准差（因为满足简单随机抽样，样本标准差总是总体标准差的无偏估计），然后还是用z分布做区间估计和假设检验；当样本量小于30，如果满足总体近似服从正态概率分布，如果总体标准差未知，可以用样本标准差去估计总体标准差，由此可用t分布做区间估计和假设检验。</p>

<blockquote>
  <p>简单总结：</p>

  <p>总体标准差已知，考虑使用Z检验；总体标准差未知，但符合正态分布（样本大于30时也认为样本符合正态分布），考虑使用T检验。</p>
</blockquote>

<h2 id="何时用单侧何时用双侧">何时用单侧？何时用双侧？</h2>

<p>何时用单侧（one-tailed）？何时用双侧（two-tailed）？双侧检验的目的是比较两个总体是否相等，用来自两个总体的样本平均数来比较。零假设为两样本所代表的总体平均数相等；备择假设为不相等（有可能甲大于乙，也有可能甲小于乙），既两种情况都有可能发生。研究者做这样的假设说明</p>

<ol>
  <li>
    <p>他没有充分的理由判断甲所代表的总体均数会大于乙的或甲的会小于乙的；</p>
  </li>
  <li>
    <p>他只关心甲乙两个样本各自所代表的总体均数是否相等？至于哪个大不是他关心的问题．</p>
  </li>
</ol>

<p>这时研究者往往会采用双侧检验。例如一个班级的平均身高是否高于或者低于另一个班级的平均身高（高于或低于也可以称为不等）。</p>

<p>而如果研究者从专业知识的角度判断甲所代表的总体均数不可能大于（或小于）乙的，这时一般就采用单侧检验。例如一个班级里男生的平均身高是否显著高于这个班级里女生的平均身高。因为研究者确信男生的平均身高大于女生的平均身高，只是想知道具体高了多少，这个差距是否有显著性。</p>

<p>那么我们是应该使用单侧检验还是双侧检验？通常，双侧检验被用于<strong>没有强烈方向性期望的实验研究</strong>中，或是存在<strong>两个可竞争的预测</strong>时。例如，当一种理论预测分数增加，而另一种理论预测分数减少时，应当使用双侧检验。应当使用单侧检验的情况包括<strong>在进行实验前已经有方向性预测</strong>，或<strong>强烈需要做出方向性预测时</strong>。</p>

<p>在使用双侧检验时，最终p值需要将计算的统计量通过查表得出的p值乘以2，而单侧检验不需要。所以就显著性而言，单侧检验能够产生比双侧检验更高的显著性（p值更小）。而双侧检验更加严格，它要求更多的证据来拒绝零假设。</p>

<h2 id="为什么t检验不能用来检验比例">为什么T检验不能用来检验比例？</h2>

<p>因为比例服从二项分布，根据中心极限定理，二项分布只有在 $n$ 很大时才服从正态分布，在小样本（$n&lt;30$）时，二项分布不服从正态分布，故无法使用T检验。</p>

<h1 id="卡方检验">卡方检验</h1>

<p>卡方检验（Chi-squared test / $\chi^2$ test ）就是<strong>统计样本的实际观测值与理论推断值之间的偏离程度</strong>。通常在给定一个多行多列的表格中，测试表格中的行是否有不同的列分布。比较两个及两个以上样本率（构成比）以及两个分类变量的关联性分析。</p>

<p>与T检验、Z检验区别：卡方检验是对两个或两个以上样本率（构成比）进行差别比较的统计方法。T检验主要是用于样本具体的值差异程度的检验方法。</p>

<ul>
  <li>
    <p><strong>条件</strong>：样本来自同一分布，并且随机采样。</p>
  </li>
  <li>
    <p><strong>优点</strong>：可以同时比较一个样本中的多个变量。</p>
  </li>
  <li>
    <p><strong>缺点</strong>：最终的结果只能表明是否独立的显著性，但是并不能给出结论是哪一行或者哪一列导致了这个结果。</p>
  </li>
  <li>
    <p><strong>举例</strong>：</p>

    <ul>
      <li>一个城市有1,000,000位居民住在4个街区A，B，C，D。每位居民可以被分类为白领，蓝领和无领。随机抽取650位居民，想要知道居民居住的街区是否跟他们的职业是独立的（住在哪里跟做什么没有关系）。数据可以由表格表示：</li>
    </ul>

    <table>
      <thead>
        <tr>
          <th> </th>
          <th>A</th>
          <th>B</th>
          <th>C</th>
          <th>D</th>
          <th>合计</th>
        </tr>
      </thead>
      <tbody>
        <tr>
          <td>白领</td>
          <td>90</td>
          <td>60</td>
          <td>104</td>
          <td>95</td>
          <td>349</td>
        </tr>
        <tr>
          <td>蓝领</td>
          <td>30</td>
          <td>50</td>
          <td>51</td>
          <td>20</td>
          <td>151</td>
        </tr>
        <tr>
          <td>无领</td>
          <td>30</td>
          <td>40</td>
          <td>45</td>
          <td>35</td>
          <td>150</td>
        </tr>
        <tr>
          <td>合计</td>
          <td>150</td>
          <td>150</td>
          <td>200</td>
          <td>150</td>
          <td>650</td>
        </tr>
      </tbody>
    </table>

    <p>（数据来源：https://en.wikipedia.org/wiki/Chi-squared_test）</p>

    <ul>
      <li>在分类资料统计分析中我们常会遇到这样的资料，如两组大白鼠在不同致癌剂作用下的发癌率如下表，问两组发癌率有无差别？</li>
    </ul>

    <table>
      <thead>
        <tr>
          <th>处理</th>
          <th>发癌数</th>
          <th>未发癌数</th>
          <th>合计</th>
          <th>发癌率%</th>
        </tr>
      </thead>
      <tbody>
        <tr>
          <td>甲组</td>
          <td>52</td>
          <td>19</td>
          <td>71</td>
          <td>73.24</td>
        </tr>
        <tr>
          <td>乙组</td>
          <td>39</td>
          <td>3</td>
          <td>42</td>
          <td>92.86</td>
        </tr>
        <tr>
          <td>合计</td>
          <td>91</td>
          <td>22</td>
          <td>113</td>
          <td>80.53</td>
        </tr>
      </tbody>
    </table>
  </li>
  <li>
    <p>计算：</p>

    <p>检验零假设 $H_0 : $ 数据的行类别与列类别是相互独立的，可以计算统计量：</p>

\[\chi^2 = \sum_{i=1}^m\sum_{i=1}^n{\frac{O_{ij}-E_{ij}}{E_{ij}}}\]

    <p>其中 $m, n$ 分别为行数和列数。$O_{ij}$ 是第 $i$ 行第 $j$ 列的观测数据，$E_{ij}$ 是第 $i$ 行第 $j$ 列的期望数据。</p>

\[E_{ij} = \frac{1}{N}\sum_{j=1}^nO_{ij}\sum_{i=1}^mO_{ij}\]

    <p>其中 $\sum_{j=1}^nO_{ij}$ 是第 $i$ 行的合计， $\sum_{i=1}^mO_{ij}$ 是第 $j$ 列的合计，$N$ 是样本总数。在上例中，住在A区的白领样	本人数是90，期	望人数是 $349 \times 150 ~/~ 650\approx80.54$。计算得出统计量 $\chi^2$ 之后，再通过自由度 $(m-1)(n-1)$，可以查 $\chi^2$ 表得出相应p值。</p>
  </li>
</ul>

<h1 id="方差分析">方差分析</h1>

<p>方差分析（One-way ANOVA）。T检验只能用于对比量组样本之间的差异显著性，如果希望检验多组样本是否源自于同一个总体，进行两两T检验的结果往往不精确，这时候可以使用ANOVA。</p>

<p>ANOVA就是单/多因素方差分析，是用来研究一个/多个控制变量的不同水平是否对观测变量产生了显著影响。</p>

<p>简单说就是分析x的变化对y的影响的显著性，所以一般变量之间存在某种影响关系的，验证一种变量的变化对另一种变量的影响显著性的检验。一般的，方差分析都是配对的。</p>

<p>区别：如果从计算来看，独立样本之间不需要进行计算，只在本组中进行计算均值、标准差等，而方差分析中，要计算数据之间的组间差异和组内差异等。</p>

<ul>
  <li>
    <p><strong>条件</strong>：每组样本独立随机采样，组数大于二。</p>
  </li>
  <li>
    <p><strong>优点</strong>：统计鲁棒性强，统计结果可靠。</p>
  </li>
  <li>
    <p><strong>缺点</strong>：当拒绝零假设时，可以知道至少其中一组的来自于不同的总体分布，但是无法得知是哪一组。</p>
  </li>
  <li>
    <p><strong>举例</strong>： 测试三种化肥对植物的生长高度的影响是否相同。假设每种化肥在6个植物上进行测试：</p>

    <table>
      <thead>
        <tr>
          <th>A</th>
          <th>B</th>
          <th>C</th>
        </tr>
      </thead>
      <tbody>
        <tr>
          <td>6</td>
          <td>8</td>
          <td>13</td>
        </tr>
        <tr>
          <td>8</td>
          <td>12</td>
          <td>9</td>
        </tr>
        <tr>
          <td>4</td>
          <td>9</td>
          <td>11</td>
        </tr>
        <tr>
          <td>5</td>
          <td>11</td>
          <td>8</td>
        </tr>
        <tr>
          <td>3</td>
          <td>6</td>
          <td>7</td>
        </tr>
        <tr>
          <td>4</td>
          <td>8</td>
          <td>12</td>
        </tr>
      </tbody>
    </table>

    <p>（数据来源：https://en.wikipedia.org/wiki/One-way_analysis_of_variance）</p>
  </li>
  <li>
    <p><strong>计算</strong>：</p>

    <p>检验零假设 $H_0 : \mu_1=\mu_2=\mu_3$ 。最终统计量是服从f分布的f统计值，中间结果可以记录在ANOVA表中：</p>

    <table>
      <thead>
        <tr>
          <th>源</th>
          <th>平方和（$SS$）</th>
          <th>自由度（$DF$）</th>
          <th>均方（$MS$）</th>
          <th>F值</th>
        </tr>
      </thead>
      <tbody>
        <tr>
          <td>方法</td>
          <td>$SST$</td>
          <td>$k-1$</td>
          <td>$MST=SST / (k-1)$</td>
          <td>$MST / MSE$</td>
        </tr>
        <tr>
          <td>误差</td>
          <td>$SSE$</td>
          <td>$N-k$</td>
          <td>$MSE=SSE / (N-k)$</td>
          <td> </td>
        </tr>
        <tr>
          <td>合计</td>
          <td>$SS$</td>
          <td>$N-1$</td>
          <td> </td>
          <td> </td>
        </tr>
      </tbody>
    </table>

    <p>其中 $N$ 是样本总数，$k$ 是方法数。$SST$ 和 $SSE$的计算如下：</p>

\[SST=\sum_{i=1}^kn_i(\bar{y}_i-\bar{y})^2\]

    <p>其中 $\bar{y}_i$ 是第 $i$ 种方法的样本均值， $\bar{y}$ 是所有样本的均值，$n_i$ 是第 $i$ 种方法的样本个数。$SSE$ 的计算如下：</p>

\[SSE=\sum_{i=1}^k\sum_{j=1}^{n_i}(y_{ij}-\bar{y}_i)^2\]

    <p>最后计算得出的F值服从 $(k-1,N-k)$ 自由度的F分布，F值越大，检验结果越显著。对比指定显著度 $\alpha$ 查F表的结果可以得出结论。在上例中，计算可得：</p>
  </li>
</ul>

\[\bar{y}_1=5,~ \bar{y}_2=9, ~\bar{y_3}=10,~ \bar{y}=8\\SST=6(5-8)^2+6(9-8)^2+6(10-8)^2=84\\SSE=(6-5)^2+(8-9)^2+...+(8-9)^2+(12-10)^2=68\\MST=SST/2=42\\MSE=SSE/15\approx 4.5\\F=MSE/MSE\approx 9.3\]

<p>通过查表，$F_{\alpha=0.05}(2,15)=3.6823&lt;9.3$，所以结论是检验结果在0.05显著度下拒绝零假设。</p>

<h1 id="曼-惠特尼u检验">曼-惠特尼U检验</h1>

<p>曼-惠特尼U检验（Mann–Whitney U test）当样本不服从正态分布，且样本个数又少的情况下，可以使用非参数检验，曼-惠特尼U检验是一种简单有效的秩和检验（通过排序名次的和作为统计量的检验）。</p>

<ul>
  <li>
    <p><strong>条件</strong>：每组样本相互独立，样本个体是有序的（两个个体可以比较大小，不能是categorical）。</p>
  </li>
  <li>
    <p><strong>优点</strong>：不用假设分布和没有样本大小需求，两个样本的大小可以不相同。</p>
  </li>
  <li>
    <p><strong>缺点</strong>：比参数检验要弱，对于真实存在差异的情况可能无法检测出显著性。</p>
  </li>
  <li>
    <p><strong>举例</strong>： 一所体育俱乐部分别选取6名黑人和6名白人，并且记录下他们所用的时间，想要检验黑人和白人的短跑速度是否有差异。（时间长短不服从正太分布，且样本之间相互独立）</p>
  </li>
  <li>
    <p><strong>计算</strong>：</p>

    <p>检验零假设 $H_0 : $ 两个总体无显著差异。</p>

    <p>先将所有样本放在一起进行排序（升序或降序）得到排名序列 ${r_1,…,r_N}$，将排名序列按不同样本拆分得到 ${r_{1,1},…,r_{1,n_1}}$, ${r_{2,1},…,r_{2,n_2}}$。其中 $n_1$, $n_2$ 是两个样本大大小。如果多个样本的值相同，则他们平分他们所在的排名位置的和。例如，有4个个体并列第4名，则他们应该被排在4,5,6,7名，所以他们的排名都是5.5。然后计算出两个样本的累计排名：</p>
  </li>
</ul>

\[R_1=\sum_{i=1}^{n_1}r_{1,i}\\R_2=\sum_{i=1}^{n_2}r_{2,i}\]

<p>U统计量的计算如下：</p>

\[U_1=R_1-n_1(n_1+1)/2\\U_2=R_2-n_2(n_2+1)/2\\U=min(U_1,U_2)\]

<p>在样本大小较大时，U统计量趋于正态分布：</p>

\[z=\frac{U-m_U}{\sigma_U}\]

<p>其中 $m_U$ 和 $\sigma_U$ 为期望和标准差：</p>

\[m_U=\frac{n_1n_2}{2}\]

\[\sigma_U=\sqrt{\frac{n_1n_2(n_1+n_2+1)}{12}}\]

<p>如果存在并列排名的情况，标准差的计算会更复杂一些：</p>

\[\sigma_U=\sqrt{\frac{n_1n_2}{12}\bigg((n+1)-\sum_{i=1}^k\frac{t_i^3-t_i}{n(n-1)}\bigg)}\]

<p>其中 $t_i$ 是并列第 $i$ 排名的个体数，$k$ 是不同的排名数。剩下的步骤就是单样本z检验问题。</p>

<ul>
  <li>
    <p><strong>业务案例</strong>：</p>

    <p>假设业务现在需要衡量一个竞足彩票推荐系统中上线的推荐模型与随机模型在每个曝光用户平均支付金额上是否有显著差异。每个曝光用户可以选择不购买该曝光彩票，也可以购买最低2元，最高2万元的彩票。由于用户购买金额是长尾的，不购买和购买2元的占绝大多数，购买高额彩票的人数很少，购买金额趋于长尾分布（power-law distribution or pareto distribution）。该分布的均值根据中心极限定理趋于稳定分布（stable distribution），而不是正态分布，故无法对其均值使用参数检验（Z检验或T检验）。然而样本数据又不是成对出现的，并且两个样本的大小不完全一致。在这种情况下，曼-惠特尼U检验是一个合适的选择，将两组样本的支付金额放在一起进行排序之后再分组，最后通过 $z$ 值得出结论。</p>
  </li>
</ul>

<h1 id="wilcoxon符号秩和检验">Wilcoxon符号秩和检验</h1>

<p>Wilcoxon符号秩和检验（Wilcoxon signed-rank test）。Wilcoxon符号秩和检验与曼-惠特尼U检验类似，都是通过秩和统计量的非参数检验。Wilcoxon符号秩和检验适用于当两组样本的个体都是成对出现的时候。</p>

<ul>
  <li>
    <p><strong>条件</strong>：每组样本相互独立，样本个体是有序的（两个个体可以比较大小，不能是categorical），样本是成对出现的（A组有一个个体，B组就有一个可以比较的个体）。</p>
  </li>
  <li>
    <p><strong>优点</strong>：不用假设分布和没有样本大小需求。</p>
  </li>
  <li>
    <p><strong>缺点</strong>：比参数检验要弱，对于真实存在差异的情况可能无法检测出显著性。</p>
  </li>
  <li>
    <p><strong>举例</strong>： 用10个数据集来测试两种算法，每个算法分别会在一个数据集上产生一个精度，则这两种算法在这10个数据集上的精度是否有显著差异？</p>
  </li>
  <li>
    <p><strong>计算</strong>：</p>

    <p>检验零假设 $H_0 : $ 两个总体无显著差异。$N$ 为样本大小，因为样本成对出现，所以总样本大小为 $2N$。对于每一对 $i=1,…,N$，有样本观测值 $x_{1,i}$ 和 $x_{2,i}$ 。计算每一对观测值的差 $d_i$ 的绝对值和差的符号 $s_i$：</p>

\[d_i=|x_{2,i}-x_{1,i}|\]

\[s_i=sgn(x_{2,i}-x_{1,i})\]

    <p>对 $d_i$ 进行升序排序，得到排名序列 ${r_1,…,r_N}$ 。如果存在某个 $d_i=0$ ，则删去这一对个体然后将N减1。如果多个样本的值相同，则他们平分他们所在的排名位置的和。例如，有4个个体并列第4名，则他们应该被排在4,5,6,7名，所以他们的排名都是5.5。然后可以计算W统计量：</p>
  </li>
</ul>

\[W=\sum_{i=1}^Ns_ir_i\]

<p>W统计量就是符号秩和。在N足够大的时候，W趋于均值为0，方差为 $\sigma_W$ 的正态分布：</p>

\[z=\frac{W}{\sigma_W}\]

\[\sigma_W=\sqrt{\frac{N(N+1)(2N+1)}{6}}\]

<p>剩下的步骤就是单样本z检验问题。</p>

<ul>
  <li>
    <p><strong>业务案例</strong>：</p>

    <p>某部门提出了一个改进的机器学习分类模型，想要在8个数据集上做离线测试，对比该模型是否与正在使用的旧模型在精度上有显著差异。两个模型在8个数据集上的效果如下：</p>

    <table>
      <thead>
        <tr>
          <th> </th>
          <th style="text-align: center">旧模型</th>
          <th style="text-align: center">新模型</th>
        </tr>
      </thead>
      <tbody>
        <tr>
          <td>数据集1</td>
          <td style="text-align: center">0.85</td>
          <td style="text-align: center"><strong>0.90</strong></td>
        </tr>
        <tr>
          <td>数据集2</td>
          <td style="text-align: center"><strong>0.88</strong></td>
          <td style="text-align: center">0.87</td>
        </tr>
        <tr>
          <td>数据集3</td>
          <td style="text-align: center">0.75</td>
          <td style="text-align: center"><strong>0.81</strong></td>
        </tr>
        <tr>
          <td>数据集4</td>
          <td style="text-align: center"><strong>0.92</strong></td>
          <td style="text-align: center">0.90</td>
        </tr>
        <tr>
          <td>数据集5</td>
          <td style="text-align: center">0.86</td>
          <td style="text-align: center"><strong>0.93</strong></td>
        </tr>
        <tr>
          <td>数据集6</td>
          <td style="text-align: center">0.77</td>
          <td style="text-align: center"><strong>0.83</strong></td>
        </tr>
        <tr>
          <td>数据集7</td>
          <td style="text-align: center">0.83</td>
          <td style="text-align: center"><strong>0.91</strong></td>
        </tr>
        <tr>
          <td>数据集8</td>
          <td style="text-align: center"><strong>0.93</strong></td>
          <td style="text-align: center">0.91</td>
        </tr>
      </tbody>
    </table>

    <p>可以看出，旧模型和新模型分别赢了3次和5次，新模型并没有在8个数据集上都取得较好结果，该如何判断新模型是否比旧模型好呢？模型在数据集上的精度显然不服从任何分布，无法使用参数检验。但是数据是成对出现的，这时候就可以使用Wilcoxon秩和检验。</p>

    <p>在此问题中，零假设 $H_0$ 和备择假设 $H_1$ 分别为：</p>

\[H_0: 新旧模型精度无差异\\H_1: 新旧模型精度有差异\]

    <p>我们可以先计算出新旧模型的差的绝对值 $d_i$，然后对其进行排序得到 $r_i$：</p>

    <table>
      <thead>
        <tr>
          <th> </th>
          <th style="text-align: center">$d_i$</th>
          <th style="text-align: center">$s_i$</th>
          <th style="text-align: center">$r_i$</th>
        </tr>
      </thead>
      <tbody>
        <tr>
          <td>数据集1</td>
          <td style="text-align: center">0.05</td>
          <td style="text-align: center">+</td>
          <td style="text-align: center">4</td>
        </tr>
        <tr>
          <td>数据集2</td>
          <td style="text-align: center">0.01</td>
          <td style="text-align: center">-</td>
          <td style="text-align: center">1</td>
        </tr>
        <tr>
          <td>数据集3</td>
          <td style="text-align: center">0.06</td>
          <td style="text-align: center">+</td>
          <td style="text-align: center">5.5</td>
        </tr>
        <tr>
          <td>数据集4</td>
          <td style="text-align: center">0.02</td>
          <td style="text-align: center">-</td>
          <td style="text-align: center">2.5</td>
        </tr>
        <tr>
          <td>数据集5</td>
          <td style="text-align: center">0.07</td>
          <td style="text-align: center">+</td>
          <td style="text-align: center">7.5</td>
        </tr>
        <tr>
          <td>数据集6</td>
          <td style="text-align: center">0.06</td>
          <td style="text-align: center">+</td>
          <td style="text-align: center">5.5</td>
        </tr>
        <tr>
          <td>数据集7</td>
          <td style="text-align: center">0.07</td>
          <td style="text-align: center">+</td>
          <td style="text-align: center">7.5</td>
        </tr>
        <tr>
          <td>数据集8</td>
          <td style="text-align: center">0.02</td>
          <td style="text-align: center">-</td>
          <td style="text-align: center">2.5</td>
        </tr>
      </tbody>
    </table>

    <p>其中 $d_4$ 和 $d_8$ 共享第2,3名，所以他们的排名为 $(2+3)/2=2.5$，同理 $d_3$ 和 $d_6$，还有 $d_5$ 和 $d_7$。通过上式得到 $W=4-1+5.5-2.5+7.5+5.5+7.5-2.5=24$，$\sigma_W=14.2829$。计算得出 $z=1.6803$。双侧检验p值为0.0930。所以结论为在置信水平 $\alpha=0.1$ 时可以拒绝 $H_0$，新模型与旧模型存在显著差异。</p>
  </li>
</ul>

<h1 id="应用考虑">应用考虑</h1>

<ol>
  <li>数据的分布（属于哪种分布，个体采样是否独立，样本是否来自同一分布）。</li>
  <li>检验方法的使用条件。</li>
</ol>

<p>只要确定了数据的分布形态，一般情况下都可以找到合适的统计检验来得出统计结论。</p>

<h1 id="参考资料">参考资料</h1>

<p>[1] http://www.davidmburrow.com/whichtest.pdf</p>

<p>[2] https://en.wikipedia.org/wiki/One-way_analysis_of_variance#Example</p>

<p>[3] https://en.wikipedia.org/wiki/Mann%E2%80%93Whitney_U_test</p>

<p>[4] <a href="http://math.mercyhurst.edu/~griff/courses/m109/Lectures/sect8.4.pdf">http://math.mercyhurst.edu/~griff/courses/m109/Lectures/sect8.4.pdf</a></p>

<p>[5] <a href="https://newonlinecourses.science.psu.edu/stat200/lesson/9/9.1/9.1.2/9.1.2.1">https://newonlinecourses.science.psu.edu/stat200/lesson/9/9.1/9.1.2/9.1.2.1</a></p>

<p>[6] <a href="https://ncss-wpengine.netdna-ssl.com/wp-content/themes/ncss/pdf/Procedures/PASS/Tests_for_Two_Proportions.pdf">https://ncss-wpengine.netdna-ssl.com/wp-content/themes/ncss/pdf/Procedures/PASS/Tests_for_Two_Proportions.pdf</a></p>

<p>[7] <a href="https://newonlinecourses.science.psu.edu/stat414/node/268/">https://newonlinecourses.science.psu.edu/stat414/node/268/</a></p>

<p>[8] https://en.wikipedia.org/wiki/Central_limit_theorem</p>

<p>[9] http://www.statisticshowto.com/sample-variance/</p>

<p>[10] http://www.kean.edu/~fosborne/bstat/07b2means.html</p>

<p>感谢腾讯高级研究员陈亮对本文的指点与修改。</p>]]></content><author><name>Yang Lu (卢杨)</name><email>luyang@xmu.edu.cn</email></author><category term="统计检验" /><category term="机器学习" /><summary type="html"><![CDATA[工业界机器学习模型常需围绕业务展开，除了机器学习本身的模型评估指标外（如LogLoss、AUC、KL等），还需要针对业务目标进行相关统计信息评估，完成针对部分流量样本上线模型后的效果分析。例如，一个模型上线后因灰度测试考虑往往先分配较少流量，当讨论测试结果是否显著用以衡量新模型有效性时，就需要使用统计评估方法。本文汇总一些常用统计方法，用于分析统计量之间的关系。]]></summary></entry><entry><title type="html">机器学习中的样本量问题</title><link href="https://jasonyanglu.github.io/posts/2019/07/blog-post-3/" rel="alternate" type="text/html" title="机器学习中的样本量问题" /><published>2019-07-01T00:00:00-07:00</published><updated>2019-07-01T00:00:00-07:00</updated><id>https://jasonyanglu.github.io/posts/2019/07/blog-post-3</id><content type="html" xml:base="https://jasonyanglu.github.io/posts/2019/07/blog-post-3/"><![CDATA[<p>在机器学习业务中经常需要评估模型的效果。例如在流量划分实验A/B Test中，我们需要确定需要多少流量可以得出统计结论是模型A好还是模型B好。一个显而易见的结论是流量越多越好，但是流量切分试验做得越久，也就意味着更多损失。所以我们需要确定样本量来对流量实验进行统计检验。</p>

<p>另一个相似的问题是，我们需要多少样本量才可以使样本均值足够逼近总体均值（也就是期望），例如我们通过100次用户行为（点击或曝光）来计算得出的ctr与当天的整体ctr会有多少偏差？根据大数定律，样本均值随着样本量增大逼近分布期望，那么我们需要多少样本才能使样本均值够足够逼近期望呢？</p>

<p>这两个问题的区别是：</p>

<ul>
  <li>统计检验样本量是通过样本来计算<strong>两个总体</strong>的差异是否有显著性。</li>
  <li>采样所需样本量是计算<strong>样本和总体</strong>的偏差。</li>
</ul>

<h1 id="统计检验样本量预估">统计检验样本量预估</h1>

<h2 id="计算原理">计算原理</h2>

<p>问题描述：</p>

<p>假设有两个总体均值$\mu_0$和$\mu_1$，已知总体标准差$\sigma$，在给定显著水平$\alpha$和统计功效$1-\beta$ 时，每个实验组至少需要多少样本量$n$，才能够比较两个总体均值？</p>
<ul>
  <li>$\alpha$：Type I Error的概率，即当零假设成立时拒绝零假设的概率。</li>
  <li>$\beta$：Type II Error的概率，即当零假设不成立时不拒绝零假设的概率。</li>
  <li>$1-\beta$：当零假设不成立时拒绝零假设的概率。</li>
</ul>

<p>该问题的零假设与备择假设为：</p>

\[H_0:\mu_0-\mu_1=0\\H_1:\mu_0-\mu_1=\delta\]

<p>通过计算可得，零假设$H_0$的临界值为</p>

\[z_{1-\alpha/2}\sigma\sqrt{2/n}\]

<p>其中$\sigma\sqrt{2/n}$是均值的标准差，通过两个总体的方差相加和中心极限定理计算得出。备择假设$H_1$的临界值为</p>

\[\delta - z_{1-\beta}\sigma\sqrt{2/n}\]

<p>临界值在0与$\beta$之间，代表在给定标准差时的不确定性。令两个临界值相等可得：</p>

\[n = \frac{2(z_{1-\alpha/2} + z_{1-\beta})^2\sigma^2}{（\mu_0 - \mu_1)^2}\]

<p>即当$n$满足该式时，我们则可以在给定显著水平$\alpha$和统计功效$1-\beta$比较两个总体均值。通常当$\alpha=0.05$和$1-\beta=0.8$时，可以用近似值快速计算$n$：</p>

\[n = \frac{16\sigma^2}{\delta^2}\]

<p>在实际计算中，我们需要<strong>预估</strong>备择假设中两个总体的均值差异$\delta$。</p>

<p><strong>注</strong>：</p>

<ol>
  <li>如果该问题是单样本问题，则将计算$n$的公式里的分子中的2去掉。</li>
  <li>如果该问题是单侧检验问题，则使用$z_{1-\alpha}$来替代$z_{1-\alpha/2}$。</li>
  <li>如果两个样本的方差不同，则将(4)分子中的$\sigma^2$替换成$\sigma_0^2 + \sigma_1^2$。</li>
</ol>

<h2 id="计算流程">计算流程</h2>

<ol>
  <li>通过给定显著水平$\alpha$和统计功效$1-\beta$，查表得出相应的$z$值$z_{1-\alpha/2}$和$z_{1-\beta}$。</li>
  <li>预估总体均值差异$\delta$和方差$\sigma^2$，如果无法预估，可以通过一小段时间的快速实验的样本均值差异$\bar{\delta}$和样本方差$\bar{\sigma}^2$来取值。</li>
  <li>通过公式(4)计算得出$n$。</li>
  <li>进行流量实验，对每个实验组取$n$个样本，并进行统计检验。</li>
</ol>

<h2 id="业务案例">业务案例</h2>

<p>现一推荐系统随机推荐ctr为0.5，准备上线模型推荐，预期ctr提升0.01。因为ctr服从伯努利分布，其方差为$\sigma=p(1-p)$。当$\alpha=0.05$和$1-\beta=0.8$时，根据方差不同版本的(4)计算可得：</p>

\[n=\frac{16\times(0.5\times 0.5+ 0.51\times 0.49)}{0.01^2}\approx 79983\]

<p>通过流量实验对随机组和模型组分别取79983个样本，并使用双比例z检验计算z值和p值。</p>

<p>CASE 1 （显著结论）：随机ctr为0.498，模型ctr为0.504，计算得出$z_{1-\alpha/2}=2.39$。通过查表得出p值为0.0168。则结论为模型推荐比随机推荐有显著差异，并且两种推荐方式无差异时得出该结论的概率小于0.0168。</p>

<p>CASE 2（不显著结论）：随机ctr为0.498，模型ctr为0.501，计算得出$z_{1-\alpha/2}=1.19$。通过查表得出p值为0.234。则结论为模型推荐比随机推荐无显著差异，并且两种推荐方式差异为0.01的情况下得出该结论的概率小于0.0516（通过将$n$，$z_{1-\alpha/2}$代回(1)中计算得出$z_{1-\beta}$）。</p>

<h2 id="参考资料">参考资料</h2>

<ol>
  <li>Van Belle, Gerald. Statistical rules of thumb. Vol. 699. John Wiley &amp; Sons, 2011.</li>
</ol>

<h1 id="采样所需样本量预估">采样所需样本量预估</h1>

<h2 id="计算原理-1">计算原理</h2>

<p>问题描述：</p>

<p>假设总体均值为$\mu$，需要在该总体中采样多少样本$n$，才能使样本均值$\bar{x}$与$\mu$的差异大于$\epsilon$的概率小于$\delta$？</p>

<p>该问题可以采用Hoeffding不等式：</p>

\[P(\rvert \bar{x}\rvert - \mu\rvert  \ge \epsilon) \le 2\exp(-2n\epsilon^2)\]

<p>该不等式说明了样本均值$\bar{x}$与总体均值$\mu$的差异大于$\epsilon$的概率的上界是$2\exp(-2n\epsilon^2)$。令$P(\rvert \bar{x} - \mu\rvert  \ge \epsilon)=\delta$，得出：</p>

\[n=\frac{-\log(\delta/2)}{2\epsilon^2}\]

<p>从该式可以看出，样本量跟概率$\delta$和差异$\epsilon$成反比，即要求$\epsilon$更小或概率$\delta$更小，则需要更大的样本量$n$。</p>

<p>同理，也可以固定$n$和$\delta$计算$\epsilon$：</p>

\[\epsilon = \sqrt{\frac{-\log(\delta/2)}{2n}}\]

<p>公式(7)默认样本的取值范围为[0,1]，例如比率。如果样本取值范围不是0~1，则使用：</p>

\[n=\frac{-\log(\delta/2)(b-a)^2}{2\epsilon^2}\]

<p>其中$a$和$b$是样本取值的上下界。</p>

<p><strong>注</strong>：</p>

<ol>
  <li>如果只需要计算$\bar{x} - \mu&gt;\epsilon$或者$\bar{x} - \mu&lt;\epsilon$的概率，则(7)的右侧变为$\exp(-2n\epsilon^2)$。</li>
</ol>

<h2 id="计算流程-1">计算流程</h2>

<ol>
  <li>给定目标差异$\epsilon$和概率$\delta$。</li>
  <li>根据样本取值范围通过等式(8)或(10)计算所需样本量$n$。</li>
</ol>

<h2 id="业务案例-1">业务案例</h2>

<h3 id="1-画像性别特征">1. 画像性别特征</h3>

<p>已知一组画像数据中总体性别特征存在少许错误，则至少需要多少样本量<em>n</em>，才能够使样本性别准确率与总体性别准确率差异不超过0.01的概率不超过5%？</p>

<p>通过等式(8)计算可得：</p>

\[n=\frac{-\log(5\%/2)}{2\times 0.01^2}\approx18444\]

<p>所以当样本量大于18444时，样本性别准确率与总体性别准确率差异不超过1%的概率不超过0.05。也就是说，采样18444个样本重复100次，样本均值和总体均值差异超过1%不会超过5次。</p>

<h3 id="2-新闻推荐ctr">2. 新闻推荐CTR</h3>

<p>在新闻推荐业务中，观测数据发现凌晨1点到2点的CTR高于全天CTR，想要分析产生该现象的原因是由于凌晨用户点击推荐新闻意愿更高，还是由于凌晨数据量少产生的采样偏差。1点到2点的曝光PV为3070，CTR为1.66%，全天曝光PV为954605，CTR为0.9%。由于全天曝光PV较大，可以将其CTR当做总体CTR，则我们需要计算CTR差值超过1.66%-0.9%=0.76%的概率最高是多少。由于我们只需要计算大于差值的概率，所以将等式(7)改为：</p>

\[P(CTR - \overline{CTR} \ge \epsilon) \le \exp(-2n\epsilon^2)\]

<p>计算可得：</p>

\[P(CTR - \overline{CTR} \ge 0.0076) \le 70.14\%\]

<p>可得出结论1点到2点的CTR比全天CTR高0.76%以上的概率上界为0.7014，说明有很大几率是由于样本量不足导致的偏差。</p>

<h2 id="查询表格">查询表格</h2>

<p>列代表差异$\epsilon$，行代表概率$\delta$。</p>

<h3 id="双侧偏差">双侧偏差</h3>

<table>
  <thead>
    <tr>
      <th> </th>
      <th>$\epsilon=0.0001$</th>
      <th>$\epsilon=0.001$</th>
      <th>$\epsilon=0.01$</th>
      <th>$\epsilon=0.05$</th>
      <th>$\epsilon=0.1$</th>
      <th>$\epsilon=0.2$</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>$\delta=0.001\%$</td>
      <td>610,303,632</td>
      <td>6,103,036</td>
      <td>61,030</td>
      <td>2,441</td>
      <td>610</td>
      <td>153</td>
    </tr>
    <tr>
      <td>$\delta=0.01\%$</td>
      <td>495,174,378</td>
      <td>4,951,744</td>
      <td>49,517</td>
      <td>1,981</td>
      <td>495</td>
      <td>124</td>
    </tr>
    <tr>
      <td>$\delta=0.1\%$</td>
      <td>380,045,123</td>
      <td>3,800,451</td>
      <td>38,005</td>
      <td>1,520</td>
      <td>380</td>
      <td>95</td>
    </tr>
    <tr>
      <td>$\delta=0.5\%$</td>
      <td>299,573,227</td>
      <td>2,995,732</td>
      <td>29,957</td>
      <td>1,198</td>
      <td>300</td>
      <td>75</td>
    </tr>
    <tr>
      <td>$\delta=1.0\%$</td>
      <td>264,915,868</td>
      <td>2,649,159</td>
      <td>26,492</td>
      <td>1,060</td>
      <td>265</td>
      <td>66</td>
    </tr>
    <tr>
      <td>$\delta=5.0\%$</td>
      <td>184,443,973</td>
      <td>1,844,440</td>
      <td>18,444</td>
      <td>738</td>
      <td>184</td>
      <td>46</td>
    </tr>
    <tr>
      <td>$\delta=10.0\%$</td>
      <td>149,786,614</td>
      <td>1,497,866</td>
      <td>14,979</td>
      <td>599</td>
      <td>150</td>
      <td>37</td>
    </tr>
    <tr>
      <td>$\delta=20.0\%$</td>
      <td>115,129,255</td>
      <td>1,151,293</td>
      <td>11,513</td>
      <td>461</td>
      <td>115</td>
      <td>29</td>
    </tr>
    <tr>
      <td>$\delta=30.0\%$</td>
      <td>94,855,999</td>
      <td>948,560</td>
      <td>9,486</td>
      <td>379</td>
      <td>95</td>
      <td>24</td>
    </tr>
    <tr>
      <td>$\delta=40.0\%$</td>
      <td>80,471,896</td>
      <td>804,719</td>
      <td>8,047</td>
      <td>322</td>
      <td>80</td>
      <td>20</td>
    </tr>
    <tr>
      <td>$\delta=50.0\%$</td>
      <td>69,314,718</td>
      <td>693,147</td>
      <td>6,931</td>
      <td>277</td>
      <td>69</td>
      <td>17</td>
    </tr>
  </tbody>
</table>

<h3 id="单侧偏差">单侧偏差</h3>

<table>
  <thead>
    <tr>
      <th> </th>
      <th>$\epsilon=0.0001$</th>
      <th>$\epsilon=0.001$</th>
      <th>$\epsilon=0.01$</th>
      <th>$\epsilon=0.05$</th>
      <th>$\epsilon=0.1$</th>
      <th>$\epsilon=0.2$</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>$\delta=0.001\%$</td>
      <td>575,646,273</td>
      <td>5,756,463</td>
      <td>57,565</td>
      <td>2,303</td>
      <td>576</td>
      <td>144</td>
    </tr>
    <tr>
      <td>$\delta=0.01\%$</td>
      <td>460,517,019</td>
      <td>4,605,170</td>
      <td>46,052</td>
      <td>1,842</td>
      <td>461</td>
      <td>115</td>
    </tr>
    <tr>
      <td>$\delta=0.1\%$</td>
      <td>345,387,764</td>
      <td>3,453,878</td>
      <td>34,539</td>
      <td>1,382</td>
      <td>345</td>
      <td>86</td>
    </tr>
    <tr>
      <td>$\delta=0.5\%$</td>
      <td>264,915,868</td>
      <td>2,649,159</td>
      <td>26,492</td>
      <td>1,060</td>
      <td>265</td>
      <td>66</td>
    </tr>
    <tr>
      <td>$\delta=1.0\%$</td>
      <td>230,258,509</td>
      <td>2,302,585</td>
      <td>23,026</td>
      <td>921</td>
      <td>230</td>
      <td>58</td>
    </tr>
    <tr>
      <td>$\delta=5.0\%$</td>
      <td>149,786,614</td>
      <td>1,497,866</td>
      <td>14,979</td>
      <td>599</td>
      <td>150</td>
      <td>37</td>
    </tr>
    <tr>
      <td>$\delta=10.0\%$</td>
      <td>115,129,255</td>
      <td>1,151,293</td>
      <td>11,513</td>
      <td>461</td>
      <td>115</td>
      <td>29</td>
    </tr>
    <tr>
      <td>$\delta=20.0\%$</td>
      <td>80,471,896</td>
      <td>804,719</td>
      <td>8,047</td>
      <td>322</td>
      <td>80</td>
      <td>20</td>
    </tr>
    <tr>
      <td>$\delta=30.0\%$</td>
      <td>60,198,640</td>
      <td>601,986</td>
      <td>6,020</td>
      <td>241</td>
      <td>60</td>
      <td>15</td>
    </tr>
    <tr>
      <td>$\delta=40.0\%$</td>
      <td>45,814,537</td>
      <td>458,145</td>
      <td>4,581</td>
      <td>183</td>
      <td>46</td>
      <td>11</td>
    </tr>
    <tr>
      <td>$\delta=50.0\%$</td>
      <td>34,657,359</td>
      <td>346,574</td>
      <td>3,466</td>
      <td>139</td>
      <td>35</td>
      <td>9</td>
    </tr>
  </tbody>
</table>

<h2 id="参考资料-1">参考资料</h2>

<ol>
  <li>https://en.wikipedia.org/wiki/Hoeffding%27s_inequality</li>
</ol>

<p>感谢腾讯高级研究员陈亮对本文的指点与修改。</p>]]></content><author><name>Yang Lu (卢杨)</name><email>luyang@xmu.edu.cn</email></author><category term="统计检验" /><category term="机器学习" /><category term="样本量问题" /><summary type="html"><![CDATA[在机器学习业务中经常需要评估模型的效果。例如在流量划分实验A/B Test中，我们需要确定需要多少流量可以得出统计结论是模型A好还是模型B好。一个显而易见的结论是流量越多越好，但是流量切分试验做得越久，也就意味着更多损失。所以我们需要确定样本量来对流量实验进行统计检验。]]></summary></entry></feed>